

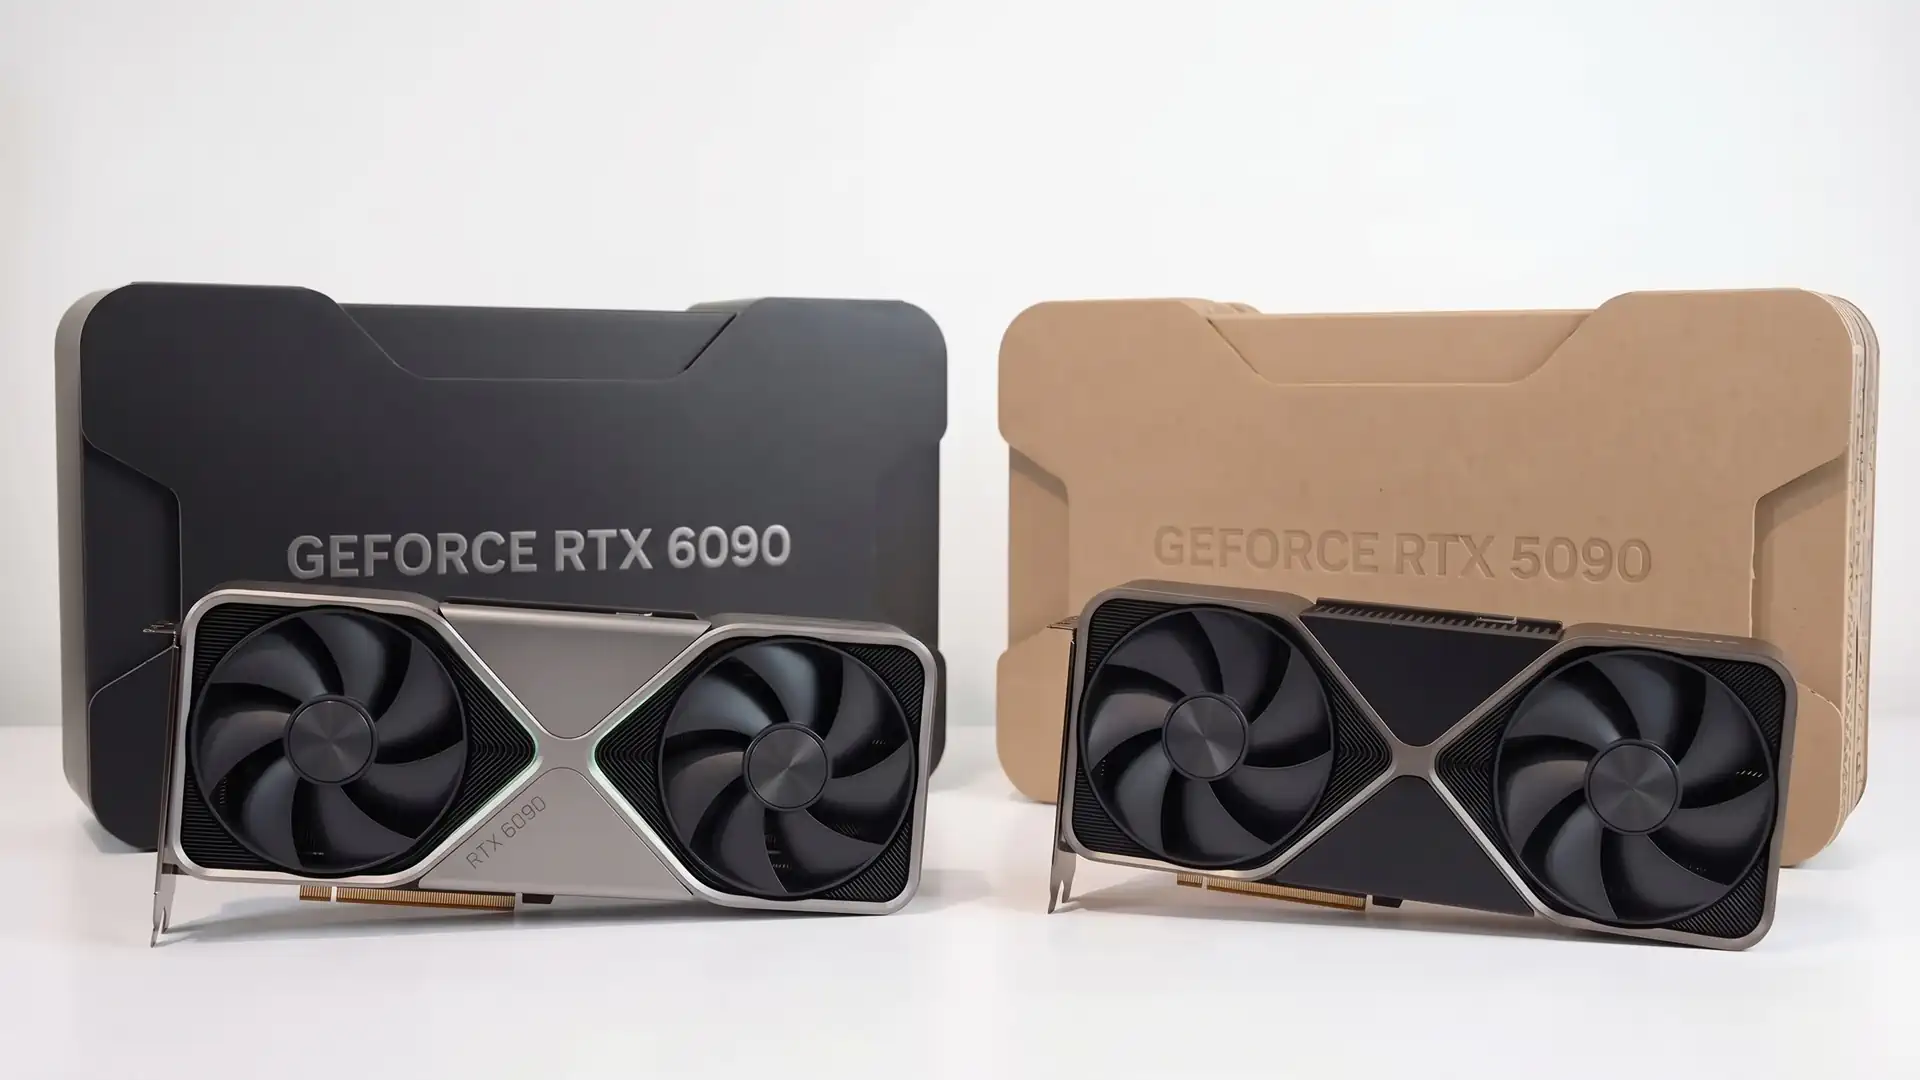
Архитектура тензорных ядер в чипах Nvidia Blackwell пятого поколения и будущей платформе Nvidia Rubin знаменует переход от генеративных нейросетей к агентным системам с непрерывными рассуждениями. Видеокарта GeForce RTX 5090 на кристалле GB202 создавалась для классического пакетного вывода токенов, локального инференса базовых языковых моделей и работы алгоритмов масштабирования DLSS 4. Перспективный флагман GeForce RTX 6090 на базе процессора GR202 переведет локальные вычисления на выполнение многовекторных задач, где ядра шестого поколения оптимизированы под непрерывный анализ контекста и выполнение разветвленных цепочек операций автономных цифровых агентов.
| Аппаратный параметр | NVIDIA GeForce RTX 5090 (Blackwell) | NVIDIA GeForce RTX 6090 (Rubin) |
| Графический процессор | GB202-300-A1 | GR202-300-A1 (Rubin Client) |
| Техпроцесс производства | TSMC 4N (5-нм класс) | TSMC 3-нм (класс N3P / N3X) |
| Количество транзисторов | Около 92,2 млрд | Свыше 150 млрд |
| Поколение тензорных ядер | 5-е поколение | 6-е поколение |
| Активные тензорные ядра | 680 блоков | Около 768 блоков |
| Базовые форматы данных | FP4, FP6, FP8, INT4, INT8, BF16, FP16 | NVFP4 (микро-блоковый), FP8, BF16 |
| Пиковая производительность | Около 3352 AI TOPS | Более 5000 AI TOPS |
| Объем и тип видеопамяти | 32 ГБ GDDR7 | 32–48 ГБ GDDR7 (On-Die ECC) |
| Пропускная способность памяти | 512-бит шина / до 1,79 ТБ/с | 512-бит шина / до 2,0 ТБ/с |
| Энергопотребление (TGP) | 600 Вт | 600 Вт |
Принципиальные изменения коснулись внутреннего устройства матричных блоков и алгоритмов их загрузки данными. В тензорных ядрах Blackwell матричные операции опираются на размерность вычислений K=96 и жесткую привязку к структурной разреженности 2:4. Тензорные ядра Rubin аппаратно расширяют размерность до K=128, затрачивая вдвое меньше тактов на типовые операции матричного умножения и вдвое увеличивая аппаратную отдачу на такт. Формат NVFP4 выполняет масштабирование на уровне микро-блоков данных весов без потери точности уровня BF16. Аппаратный планировщик Transformer Engine 3.0 снижает задержки ветвления алгоритмов до 10 раз без сброса кэша L2, что обеспечивает аппаратный нейронный денойзинг трассировки путей и генерацию геометрии непосредственно в реальном времени.
В совокупности архитектурные нововведения смогут обеспечить тензорным ядрам Rubin двукратный прирост чистой скорости исполнения матричных операций GEMM за такт по сравнению с Blackwell. На этапе логического вывода в низкоразрядных форматах FP4 и FP8 пропускная способность возрастает в 2 раза за счет размерности K=128. В сценариях агентного инференса с разветвленными цепочками рассуждений задержки переключения контекста сокращаются до 10 раз, а общая вычислительная мощность кристалла возрастает в 1,5 раза при росте скорости подсистемы памяти до 12%.
В реальных игровых проектах с полной трассировкой путей в разрешении 4K и 8K, таких как Cyberpunk 2077, Alan Wake 2 и будущих релизах на Unreal Engine 5, видеокарта RTX 6090 будет быстрее RTX 5090 в 1,5–2 раза за счет продвинутой нейронной реконструкции конвейера DLSS 5, мгновенного аппаратного денойзинга трассировки лучей и генерации геометрии в реальном времени.