

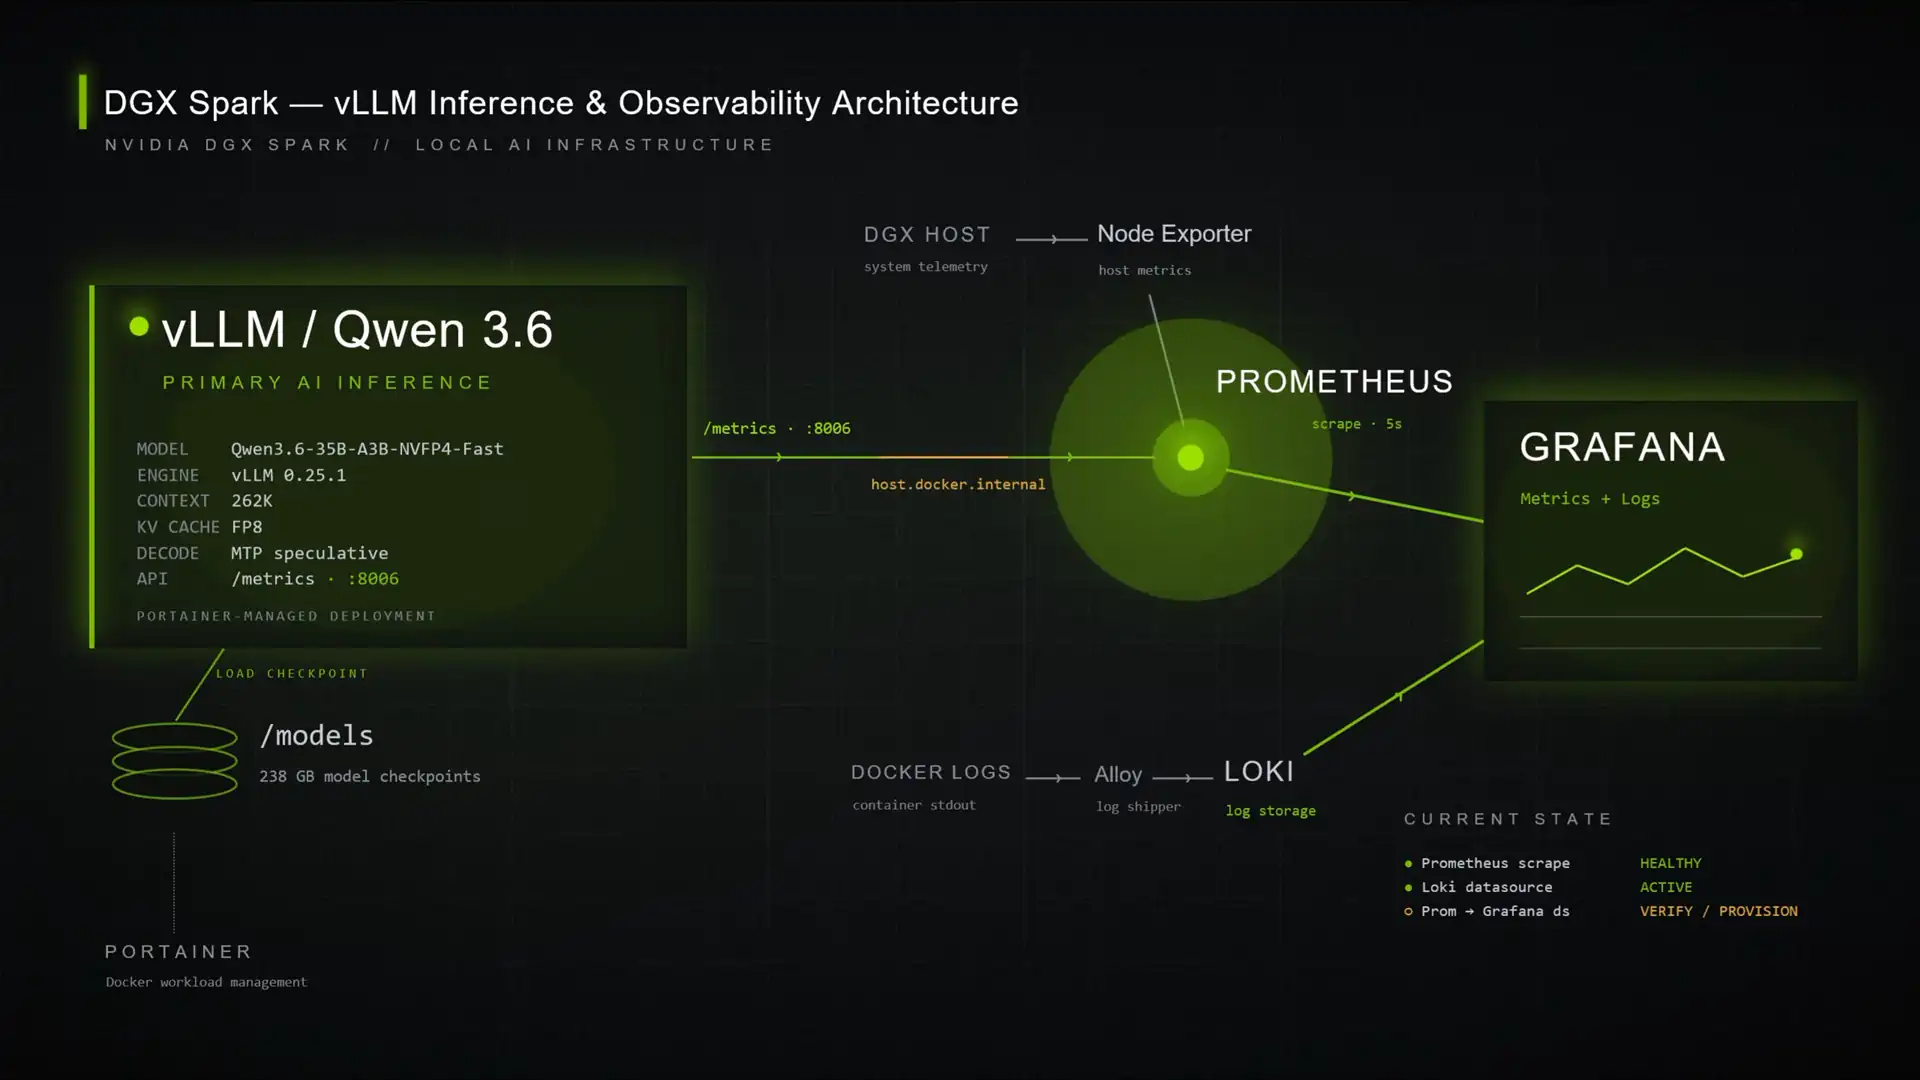
Энтузиаст Райан Сасман представил специализированный дашборд Grafana для оптимизации работы vLLM на суперчипе NVIDIA DGX Spark с микроархитектурой Grace Blackwell и 128ГБ объединенной памяти. Разработанный инструмент объединяет данные из Prometheus, Loki и Node Exporter для точного анализа параметров работы локальных языковых моделей, таких как Qwen3.6 с контекстом 262144 токенов. Система позволяет непрерывно отслеживать пропускную способность генерации, время до первого токена, загрузку кэша ключевых значений, задержки и эффективность префиксного кэширования в реальном времени.
Специальная архитектура телеметрии решает задачу точной настройки параметров vLLM без работы вслепую. Благодаря обновлению vLLM версии 25.1 разработчики получили возможность отслеживать показатели спекулятивного декодирования по позициям токенов, что помогает подбирать оптимальное число прогнозируемых элементов. На практике правильная конфигурация позволяет существенно поднять скорость работы системы с базовых 127 токенов в секунду до показателей порядка 200 токенов в секунду, а также оценить общую загрузку объединенной памяти и процессора.
Развернутый комплекс телеметрии собирает метрики системных ресурсов и логи Docker с помощью единой связки сервисов с резервированием хранилища. Создатель дашборда открыл публичный доступ к своим наработкам на GitHub, предоставив готовые конфигурационные файлы vLLM, Prometheus и Grafana. Инструмент спроектирован для разработчиков, запускающих локальные агенты, диалоговые системы или автодополнение кода, и помогает точно определить узкие места системы при выполнении сложного контекстного анализа.