

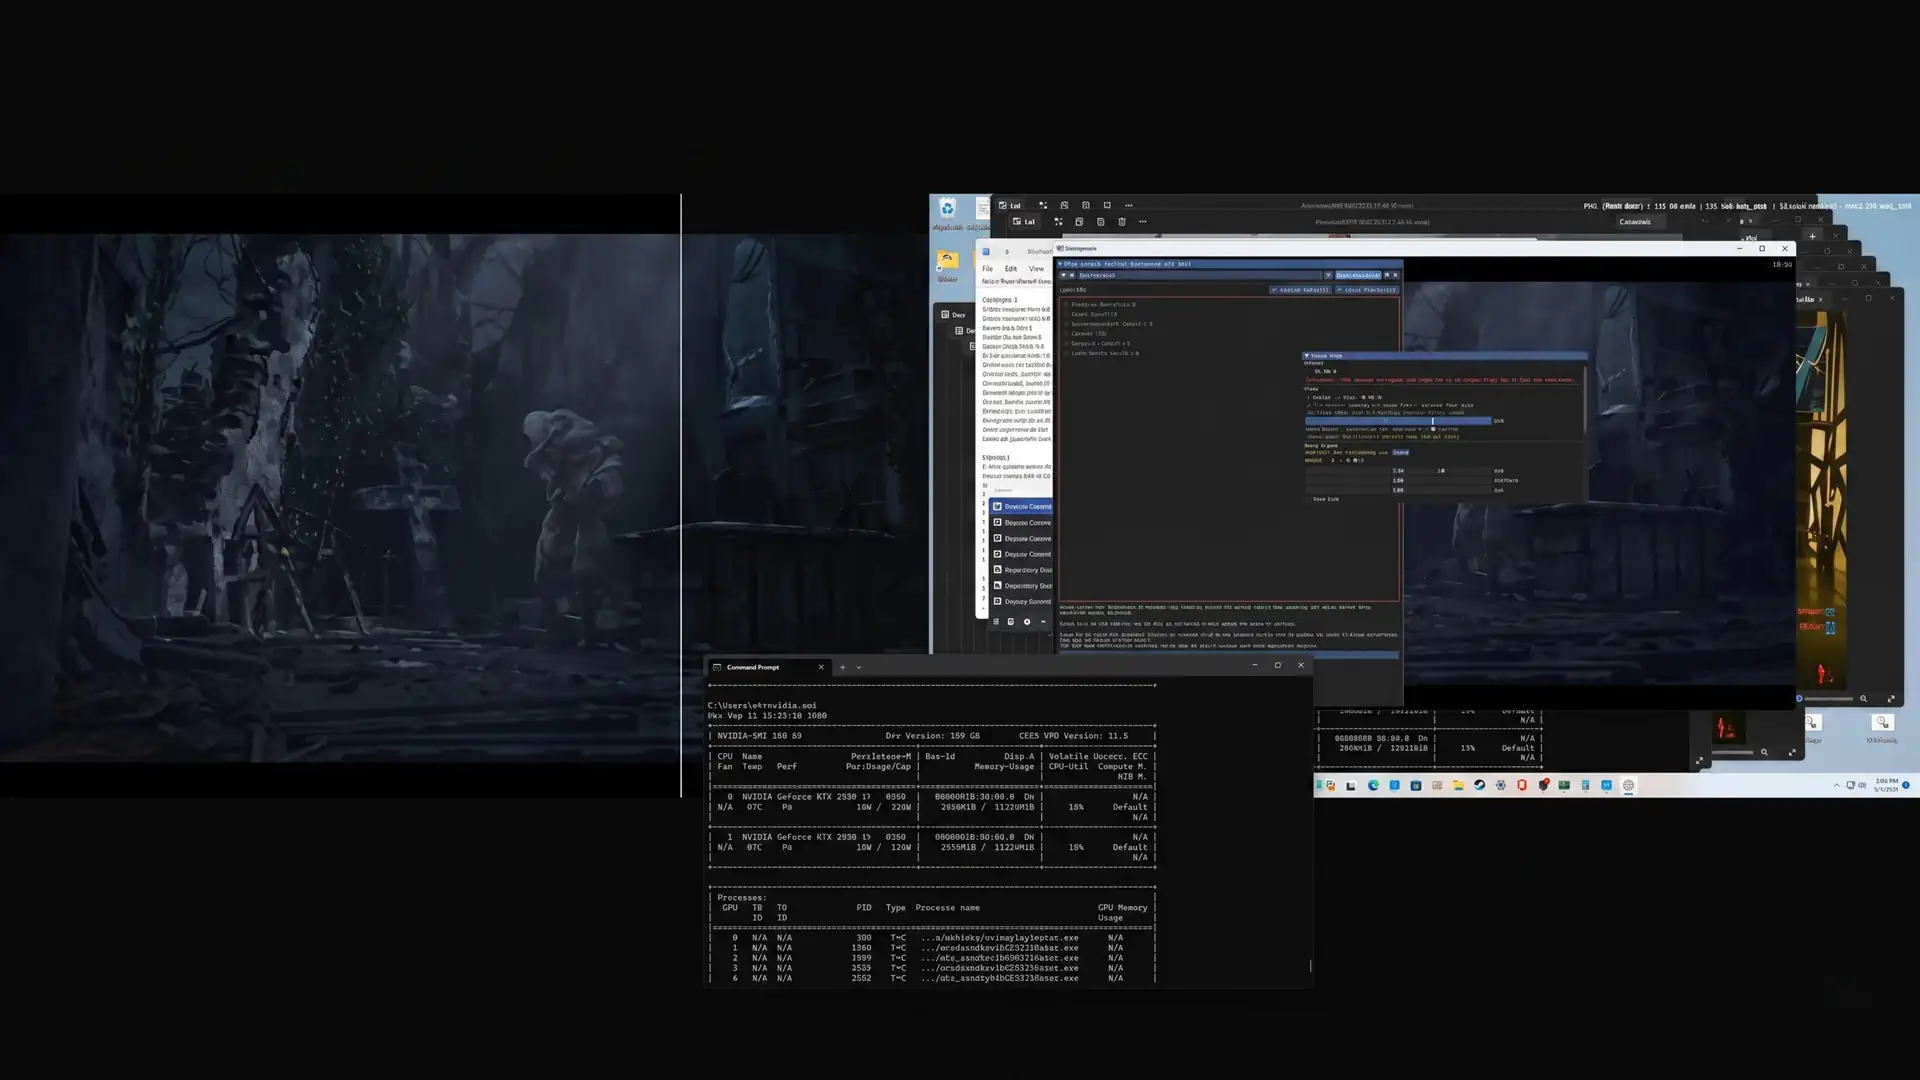
Разработчик под ником maohgad-web представил исследовательский проект Neural Coprocessor с открытым исходным кодом, предназначенный для разгрузки основного графического ускорителя. Модификация реализована в виде аддона MGPU Bridge для утилиты ReShade версии 6.8.0 или новее и ориентирована на проекты с поддержкой DirectX 12. В отличие от традиционных связок вроде SLI, здесь не происходит разделение или дублирование отрисовки кадра в процессе рендеринга. Нейросетевая постобработка DLSS 5 представляет собой терминальную стадию, поэтому аддон перехватывает уже готовый кадр через разделяемую кучу памяти cross-adapter shared heap и отправляет его на второй GPU, где запускаются библиотеки DLSS-NR, а результат выводится в отдельное окно на подключенном ко второй видеокарте мониторе.
Тестирование связки проводилось в игре The Blood of Dawnwalker в разрешении 1920x1080 на системе с двумя видеокартами GeForce RTX 5060 Ti 16 GB. На основном адаптере при включении этапа DLSS 5 кадровая частота заметно падала из-за того, что нейросетевой проход выполняется в полном выходном разрешении и отнимает вычислительные ресурсы GPU. В режиме DLAA производительность снижалась с 67-70 до 44 кадров в секунду, падение составило 36%, в режиме Quality частота опускалась с 98-99 до 54-55 кадров в секунду, падение составило 45%, в режиме Performance кадры проседали с 127-131 до 59 FPS, падение составило 54%, а в Ultra Performance показатель снижался со 172 до 69-71 FPS, что означает потерю 59% производительности.
Перенос нейросетевого блока на второй графический процессор позволил вернуть большую часть потенциала апскейлинга. В конфигурации со второй картой фреймрейт в DLAA составил те же 67-70 кадров в секунду с нулевыми потерями, в Quality достиг 91 FPS с падением всего 8%, в Performance вырос до 106-107 FPS с потерей 17%, а в Ultra Performance зафиксирован на уровне 157 кадров в секунду, что соответствует потере лишь 9% от базового потолка. При переходе от DLAA к Ultra Performance связка со вторым GPU сохранила 86% доступного прироста частоты кадров против 39% при исполнении всего пайплайна на одном чипе. Кроме того, перенос нагрузки снизил температуру рендер-карты на 10°–21° в зависимости от используемого тестового стенда.