

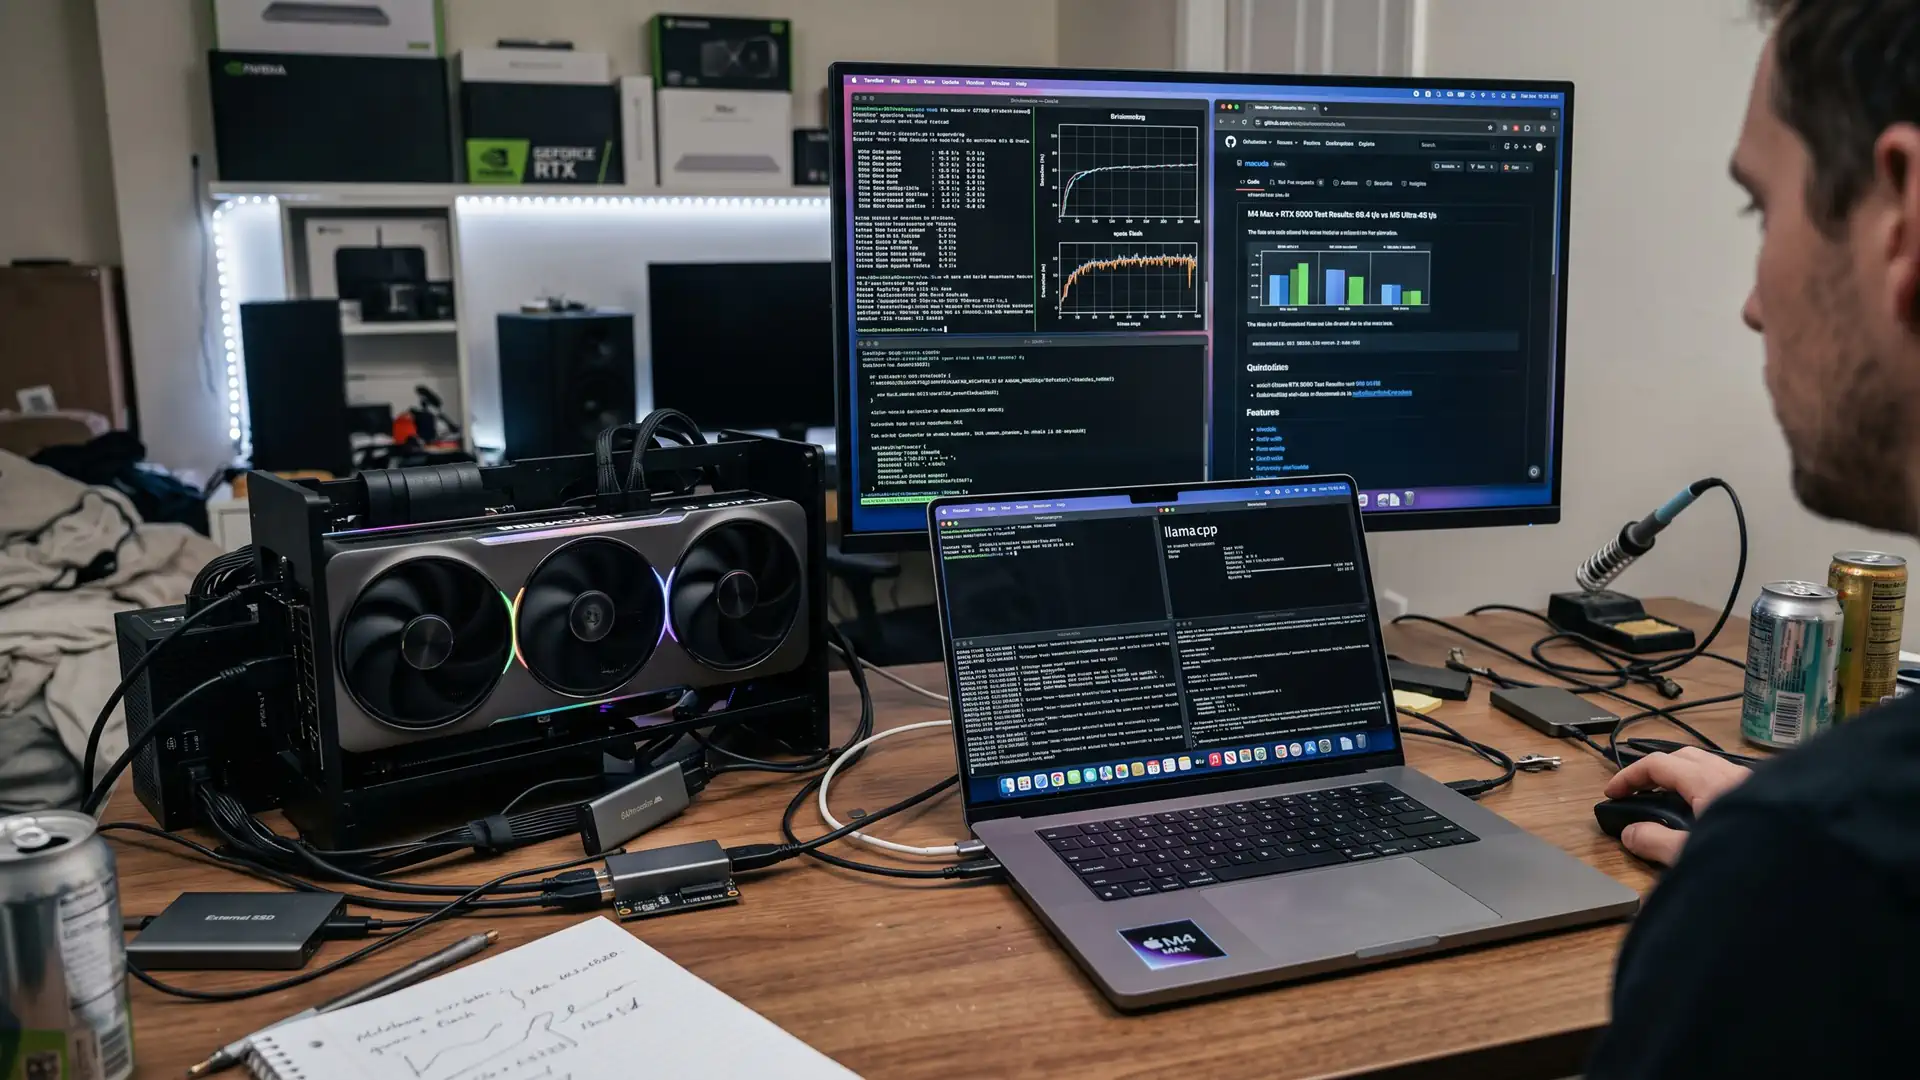
Энтузиаст с платформы Reddit под псевдонимом LioDavinchy представил результаты тестирования гибридной системы, состоящей из ноутбука Apple с процессором M4 Max и 128 ГБ объединенной памяти, а также внешней видеокарты Nvidia GeForce RTX 5090. Подключение графического ускорителя к macOS стало возможным благодаря разработке кастомного драйвера и специальной прослойки в рамках открытого проекта macuda. Автор решил проверить эффективность собственной конфигурации на языковой модели qwen flash в интерфейсе llamacpp после публикации обзоров рабочих станций Mac Studio и систем на базе Nvidia Spark, стоимость которых на рынке варьируется от $10 000 до $15 000. Главной целью эксперимента стала проверка скорости декодирования токенов и параллельной обработки запросов от нескольких клиентов.
В ходе тестов самодельная связка продемонстрировала впечатляющее превосходство над более дорогими готовыми решениями в задачах генерации. В режиме декодирования для одного пользователя система показала скорость 68.4 токена в секунду, в то время как конфигурация на M5 Ultra выдает лишь 45, а связка из двух Nvidia DGX Spark достигает показателя в 38 токенов в секунду. В стресс-тесте при одновременной нагрузке от 8 пользователей связка M4 Max и RTX 5090 набрала суммарно 155 токенов в секунду против 66–70 у M5 Ultra и 120 у пары ускорителей DGX Spark. Единственным параметром, где внешняя карта пока уступает специализированным серверам, стал холодный префилл на 32 тысячи токенов, занявший 27 секунд, тогда как рабочие станции Nvidia справляются с этой задачей за 11.2 секунды.
Автор проекта подчеркнул, что суммарные вложения в создание подобного рабочего места составили около $6 000, что в два с лишним раза дешевле корпоративных альтернатив при более высоком быстродействии. Разработчик продолжает оптимизацию стека macuda и готовит к выпуску обновление программных компонентов, совместимых также с видеокартами серий RTX 3060, RTX 4090 и профессиональным ускорителем RTX PRO 4000 SFF. Участники профильного сообщества активно подключились к тестированию решения на платформе GitHub и предлагают дальнейшие пути оптимизации вычислений, включая интеграцию алгоритмов спекулятивной выборки данных.