

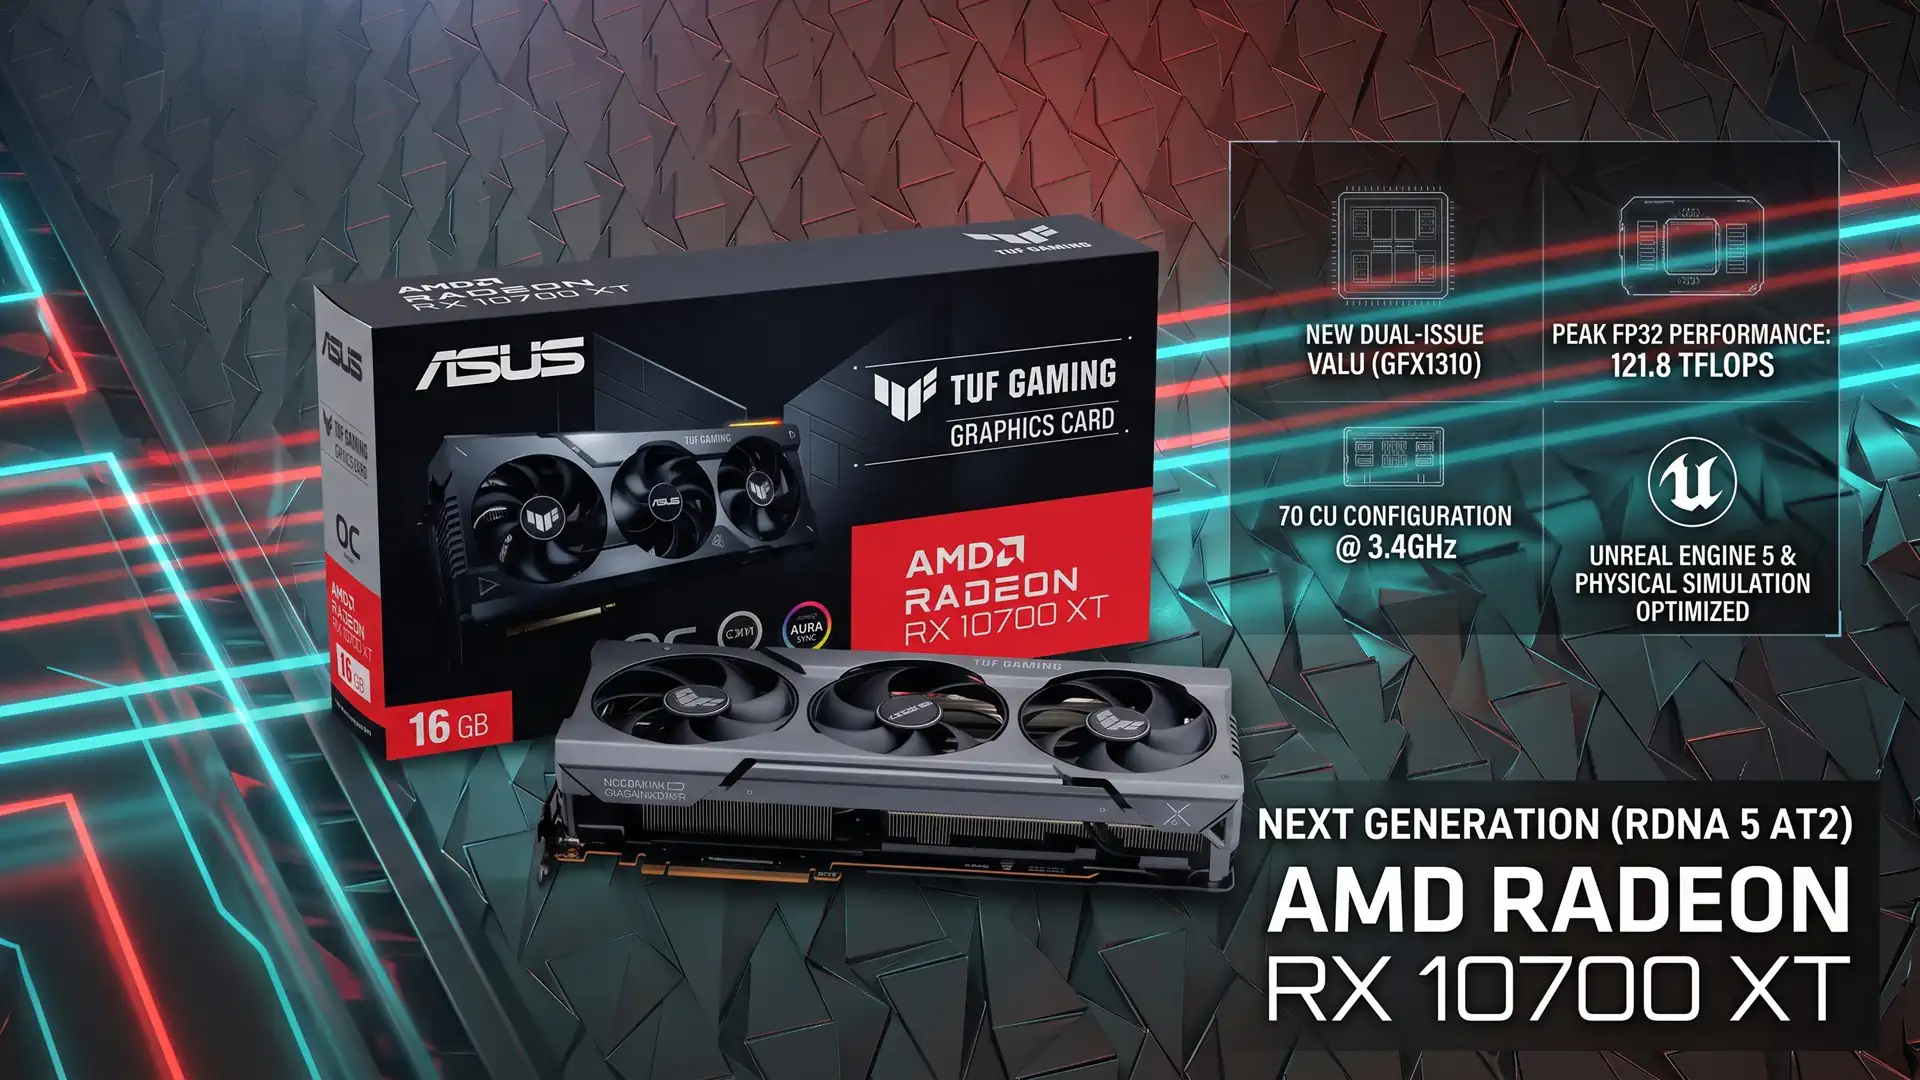
Архитектура графических процессоров AMD RDNA 5 под кодовым обозначением GFX1310 получила фундаментальные изменения конвейера Dual Issue VALU. В ранних итерациях RDNA 3 и RDNA 4 данная функциональность сталкивалась с серьезными ограничениями, включая жесткое разделение регистровых банков, изолированные операнды и отсутствие полноценной работы с инструкциями совмещенного умножения и сложения FMA. Из-за конфликтов портов компиляторы сбрасывали параллельное выполнение на линиях X и Y. В новом поколении компания сняла критические барьеры, разрешив использование общих входных регистров и внедрив полную поддержку сложных векторных команд VOP3 и FMA. Это позволяет аппаратному планировщику автоматически спаривать тяжелые шейдерные вычисления без необходимости проводить ручную низкоуровневую оптимизацию кода.
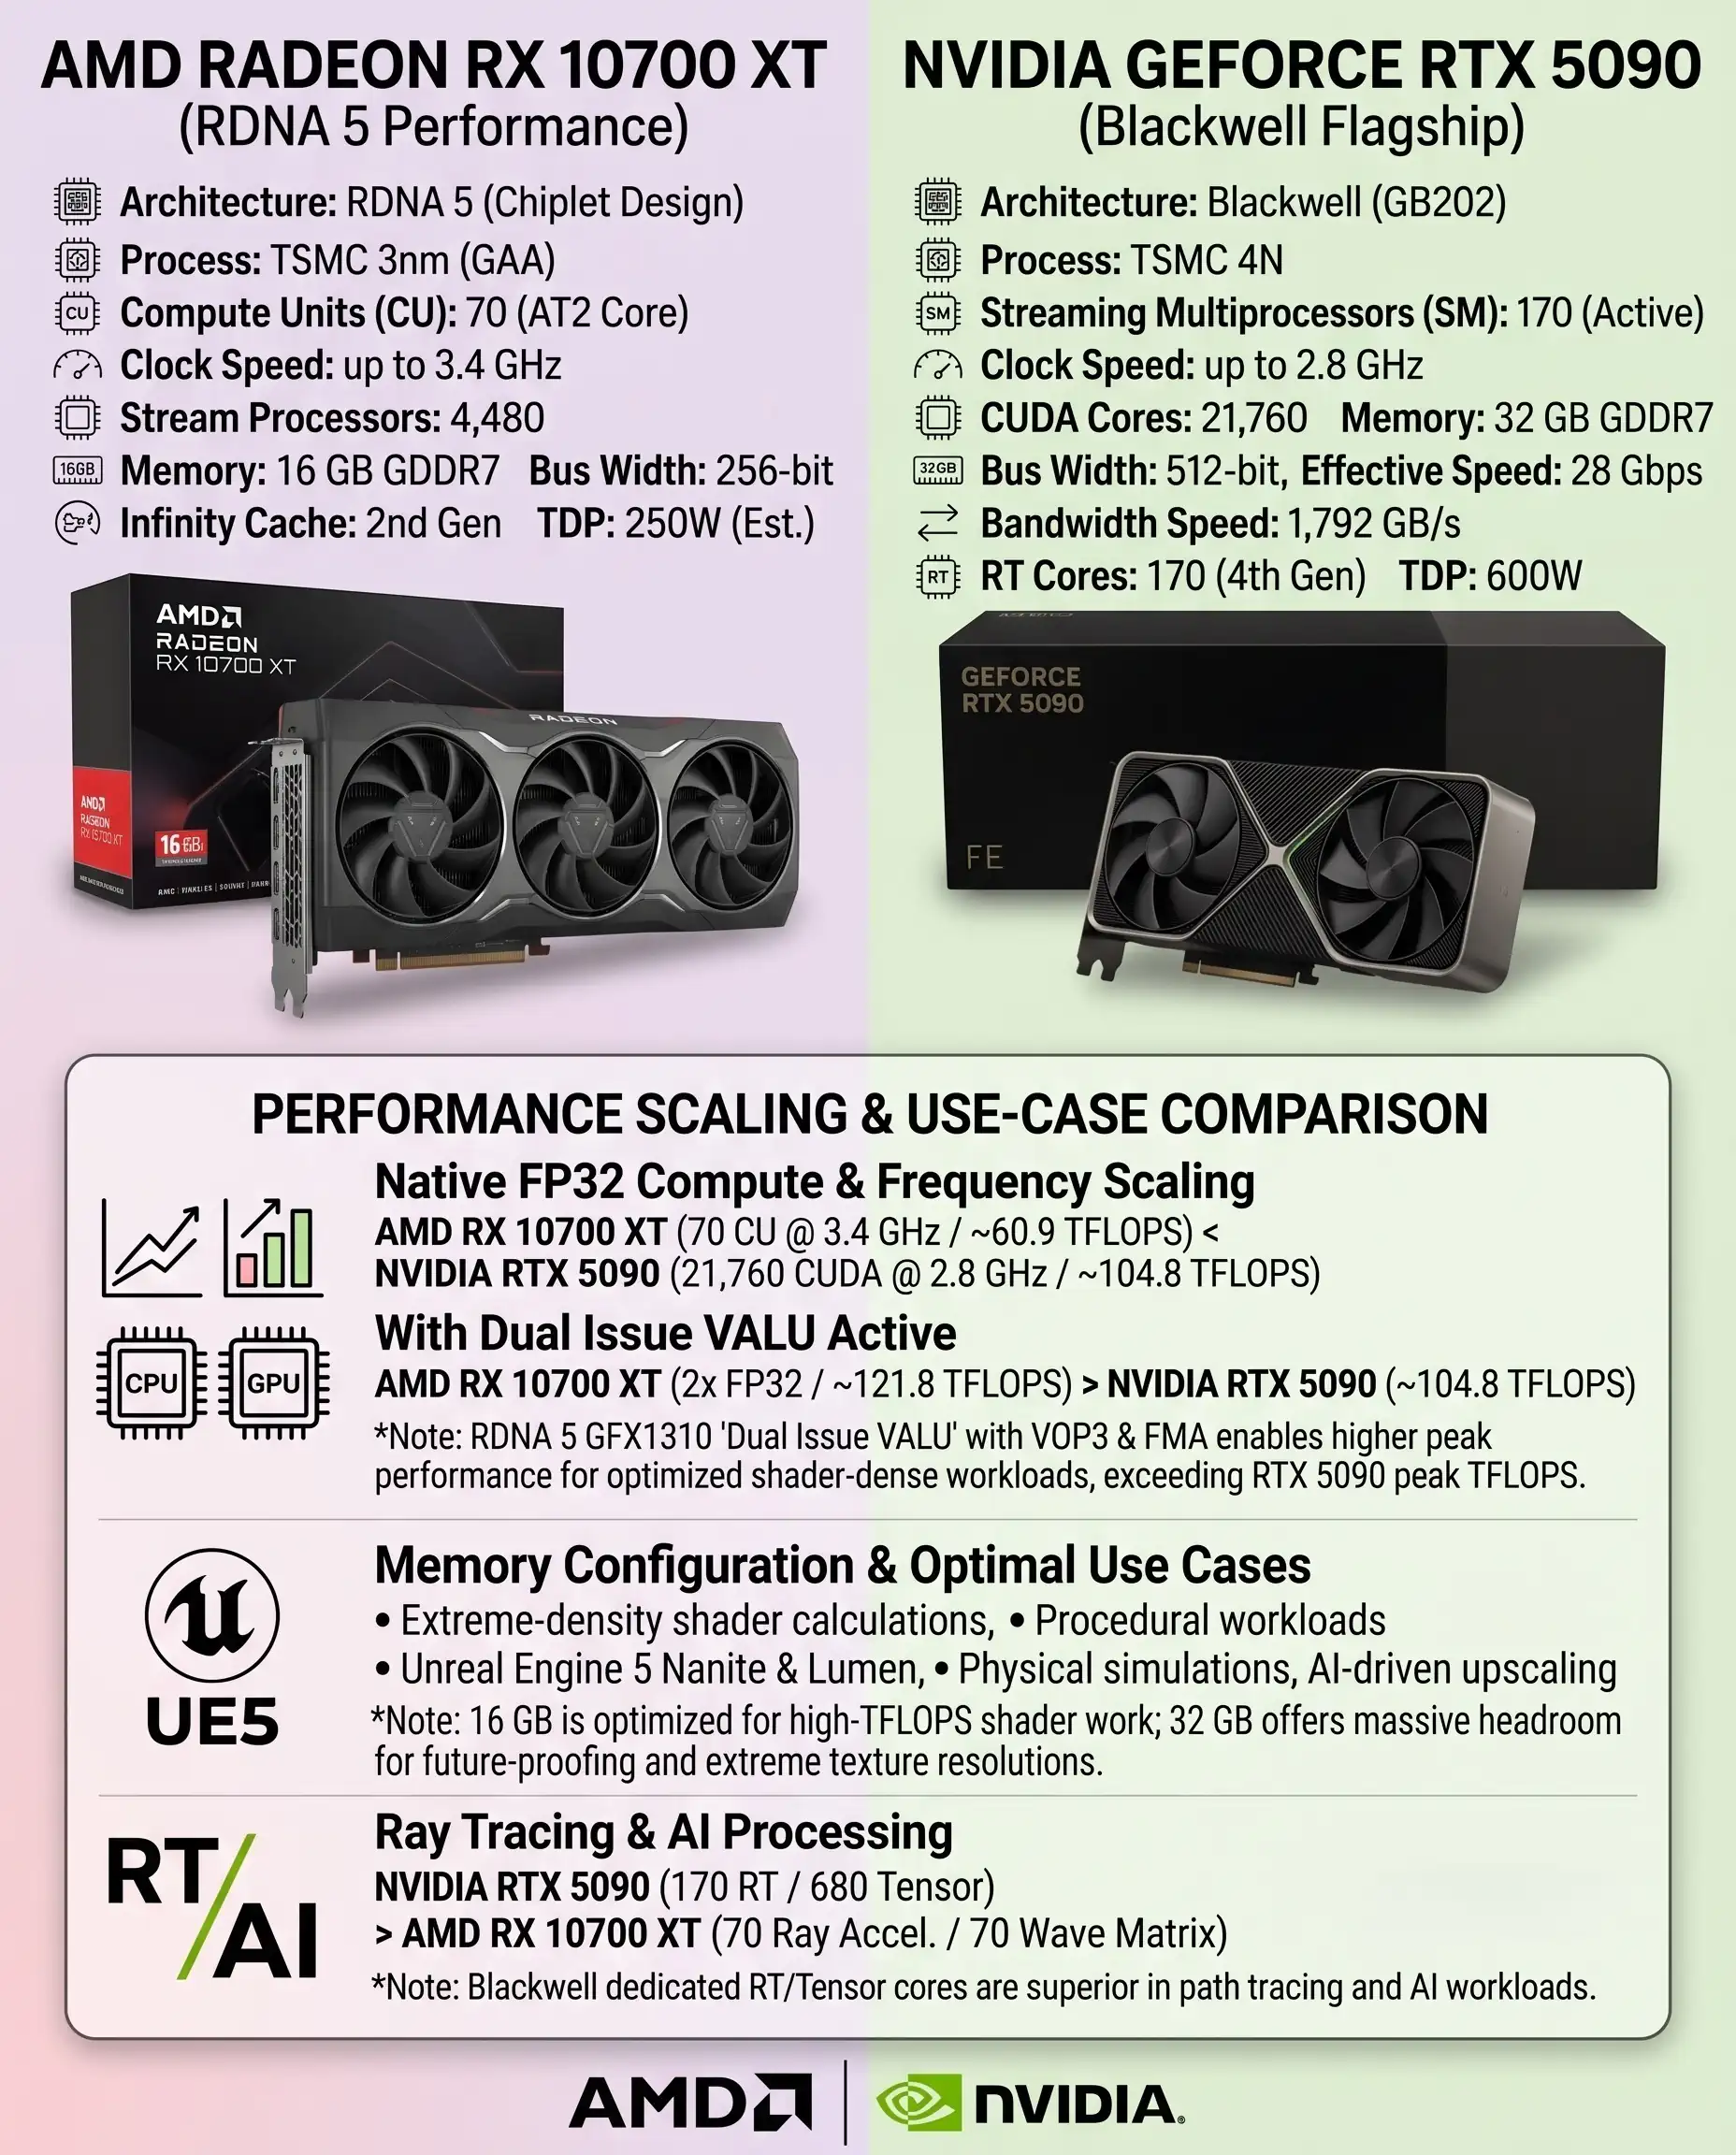
Перспективный графический процессор массового сегмента под кодовым обозначением AT2, который предназначен для предполагаемой видеокарты Radeon RX 10700 XT, получит конфигурацию с 70 вычислительными блоками CU с тактовой частотой ядра до 3,4 ГГц. Новый кристалл превзойдет актуальный чип Navi 48, установленный в Radeon RX 9070 XT и насчитывающий 64 блока CU. В результате экстенсивный прирост числа блоков составит порядка 9%, благодаря чему новинка опередит текущий флагман RDNA 4 даже без учета архитектурных модификаций. Без параллельного конвейера базовая производительность чипа в операциях одинарной точности FP32 составляет около 60,9 TFLOPS. При активации технологии Dual Issue VALU пиковая мощность достигает 121,8 TFLOPS против 104,8 TFLOPS у GeForce RTX 5090 и 48,7 TFLOPS у Radeon RX 9070 XT.
На практике подобный вычислительный перевес позволит видеокарте Radeon RX 10700 XT обходить GeForce RTX 5090 в строго определенных сценариях. Речь идет о проектах с экстремально плотной шейдерной математикой и процедурными расчетами, где нагрузка не упирается исключительно в пропускную способность подсистемы памяти или аппаратные RT-ядра. Наибольший отрыв ожидается в играх на движке Unreal Engine 5 с активными микрополигональными геометриями Nanite и программной трассировкой Lumen, где стандартные FP32-шейдеры формируют основной массив кадра. Преимущество также проявится в тяжелых вычислительных нагрузках физических симуляций, алгоритмах нейросетевого апскейлинга и проектах с кастомными шейдерами освещения.