

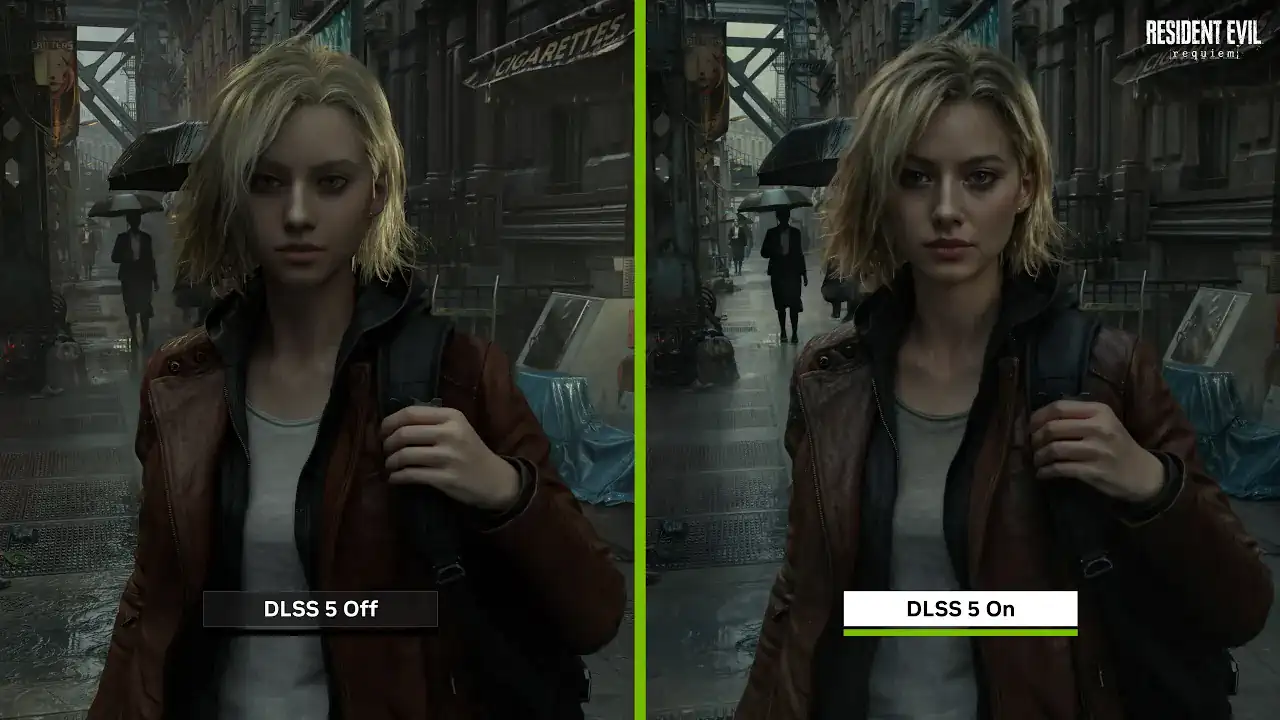
На конференции GTC 2026 компания NVIDIA официально представила DLSS 5 — технологию нейронного рендеринга (Neural Rendering), интегрируемую непосредственно в графический конвейер. В отличие от предыдущих итераций, направленных на пространственное масштабирование (Super Resolution) и генерацию промежуточных кадров (Frame Generation), пятая версия заменит классический расчет пиксельных шейдеров для освещения и материалов единой нейросетевой моделью.
Внедрение глубокой модификации рендеринга требует специфических аппаратных ресурсов, что приведёт к жесткой сегментации поддержки DLSS 5 среди существующих архитектур графических процессоров.
Архитектурные требования к конвейеру
Технология принимает на вход базовый цветовой буфер (color buffer) сцены и векторы движения (motion vectors). ИИ-модель, обученная на оффлайн-рендерах, генерирует финальное изображение с расчетом подповерхностного рассеивания для биологических тканей, преломлениявета и физически корректного поведения сложных материалов. Подобные операции в реальном времени требуют высокой производительности тензорных матричных вычислений с низкой точностью. На технической демонстрации NVIDIA использовала стенд из двух графических процессоров (один для базовой растеризации геометрии, второй — для обработки алгоритма DLSS 5), однако финальная интеграция в игровых движках, таких как Unreal Engine, рассчитана на работу в рамках одного чипа.

Ниже представлены наш технический анализ того, как архитектурные ограничения повлияют на доступность нового конвейера рендеринга для различных поколений видеокарт. Поскольку технология переносит акцент с традиционных шейдеров на тензорные вычисления, поддержка алгоритма жестко сегментируется на аппаратном уровне.
GeForce RTX 20 (Turing) и RTX 30 (Ampere): Отсутствие аппаратной совместимости
Основная проблема этих архитектур заключается в физическом отсутствии необходимых блоков для потокового выполнения логического вывода (inference) тяжелых нейросетей. Тензорные ядра второго (Turing) и третьего (Ampere) поколений проектировались преимущественно под матричные вычисления в форматах FP16 и INT8. Этого ресурса достаточно для работы алгоритмов пространственной реконструкции, но математической плотности совершенно не хватает для попиксельной генерации физики материалов и освещения в реальном времени.
Вторым критическим фактором является пропускная способность подсистемы памяти и отсутствие современного сопроцессора оптического потока (OFA). Для того чтобы нейросеть могла корректно генерировать кадр без темпоральных артефактов, ей требуются высокоточные векторы движения, передаваемые с минимальной задержкой. Аппаратные блоки OFA в RTX 20 и 30 обладают слишком низкой скоростью, что гарантированно приведет к рассинхронизации между растровым геометрическим буфером и ИИ-генерацией.
На практике это означает полное исключение данных видеокарт из экосистемы нового конвейера. В проектах с интеграцией DLSS 5 владельцы графических адаптеров серий 2000 и 3000 будут ограничены базовыми пресетами апскейла (Super Resolution). Активация нейронного формирования материалов или сложного освещения будет заблокирована на уровне видеодрайвера во избежание катастрофического падения кадровой частоты и нестабильности времени кадра (frametime).
GeForce RTX 40 (Ada Lovelace): Гибридный режим
Видеокарты серии Ada Lovelace обладают значительно более производительным блоком Optical Flow Accelerator, который успешно справляется с передачей векторов для генерации промежуточных кадров. Однако тензорные ядра четвертого поколения были архитектурно оптимизированы под формат FP8. Модель нейронного рендеринга DLSS 5 изначально создается с расчетом на вычисления сверхнизкой точности, что неизбежно создает конфликт производительности при попытке запустить полную математическую симуляцию на картах этой серии.
Наши рассуждения сводятся к тому, что NVIDIA внедрит программный уровень совместимости — гибридный профиль. Вместо полноценной нейросетевой генерации освещения и поверхностей на уровне каждого пикселя, графические процессоры RTX 40 будут выполнять этот алгоритм с пониженным внутренним разрешением сетки расчета или с упрощенной моделью предсказания. Это позволит сохранить приемлемый уровень кадровой частоты, но снизит итоговое качество реконструкции сложных PBR-материалов.
Важную роль здесь сыграет объем L2-кэша, который в архитектуре Ada Lovelace был значительно увеличен. Этот буфер частично нивелирует нагрузку на шину памяти при интенсивном обмене тензорными данными. Тем не менее, наиболее ресурсоемкие эффекты нейронного рендеринга на RTX 40, вероятнее всего, будут работать с заметными темпоральными артефактами при быстром изменении ракурса камеры или останутся недоступными.
GeForce RTX 50 (Blackwell): Целевая архитектура
Серия RTX 50 находится на рынке уже полтора года, и именно архитектура Blackwell выступает фундаментальной базой для работы технологии DLSS 5. Ключевым нововведением тензорных ядер пятого поколения стала аппаратная поддержка вычислений в формате FP4. Это позволяет графическому процессору обрабатывать ресурсоемкие нейросети в разы быстрее по сравнению с Ada Lovelace без пропорционального увеличения площади кристалла и транзисторного бюджета.
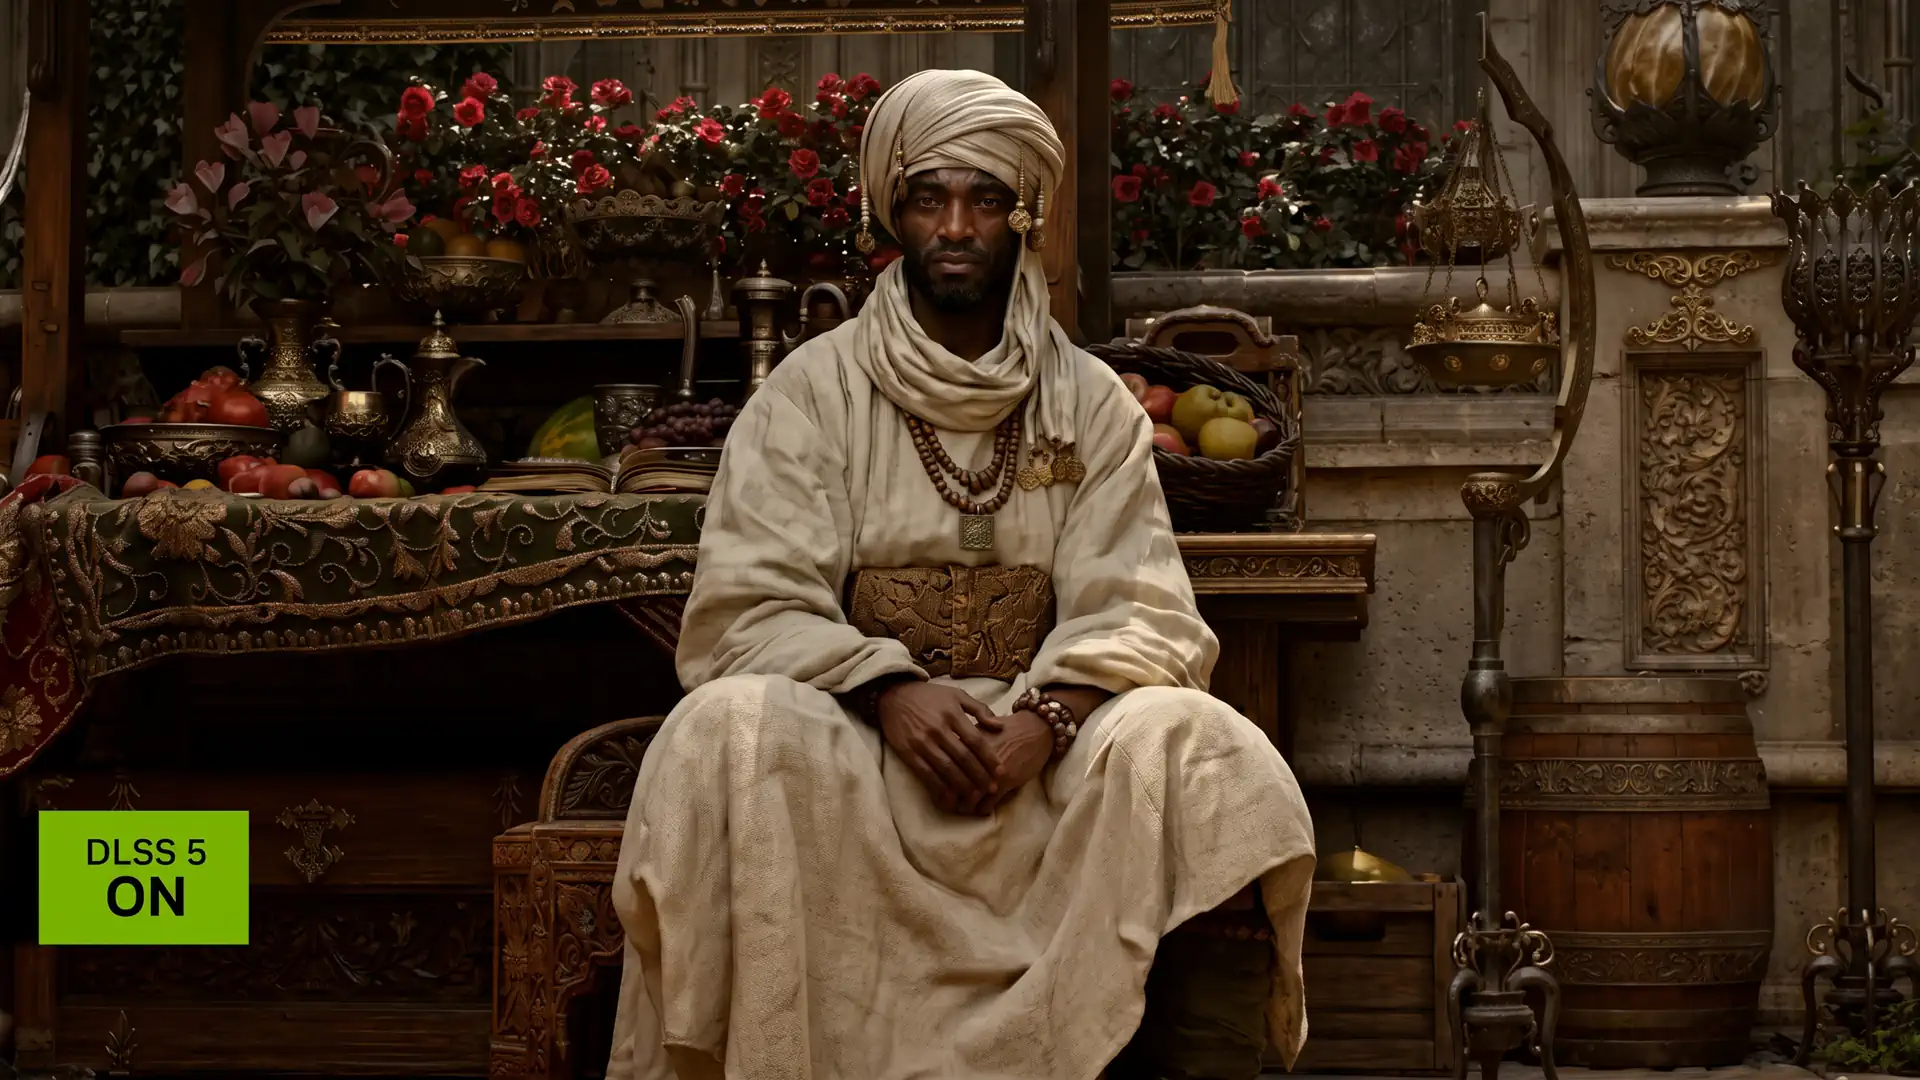
В условиях нейронного рендеринга конвейер графических чипов серии RTX 50 способен параллельно обрабатывать классическую растеризацию базовой геометрии и ИИ-генерацию финального кадра с минимальными задержками. Высокая скорость обмена данными внутри чипа исключает эффект узкого горлышка; нейросеть своевременно получает цветовой буфер сцены и векторы движения, формируя физически корректное изображение без шлейфов и разрывов.
В рамках этой архитектуры технология работает в целевом режиме без программных упрощений. Графические процессоры Blackwell способны выполнять полную симуляцию света и материалов, заменяя собой традиционные математические расчеты сложных шейдеров. Именно данная аппаратная база позволяет игровым движкам перекладывать задачи формирования фотореалистичной картинки на тензорные блоки.
GeForce RTX 60 (Следующее поколение): Прирост за счет плотности ИИ-вычислений
Хотя полные технические спецификации архитектуры RTX 60 еще не опубликованы, анализ эволюции графических конвейеров позволяет спрогнозировать ее поведение в нейронном рендеринге. Основной прирост производительности будет достигнут не за счет внедрения новых типов данных, а благодаря кратному увеличению математической плотности тензорных операций на такт. Ядра следующего поколения сократят время выполнения нейросетевого прохода до долей миллисекунды.
Вторым фактором архитектурного превосходства станет глубокая переработка подсистемы памяти и кэширования. Обработка семантики кадра в реальном времени требует экстремальной пропускной способности. Переход на более высокочастотные стандарты видеопамяти в связке с расширенной шиной данных позволит RTX 60 обрабатывать массивы геометрических буферов без внутренних задержек, полностью устраняя инпут-лаг при генерации.
В результате, если для архитектуры Blackwell алгоритм DLSS 5 является тяжелой вычислительной нагрузкой, утилизирующей значительный процент ресурсов чипа, то для RTX 60 этот процесс перейдет в разряд базовых операций. Освободившаяся чистая растровая и вычислительная мощность графического процессора пойдет на обработку увеличенной геометрической сложности сцены или повышение базового внутреннего разрешения рендера до того, как кадр попадет в нейросеть.