

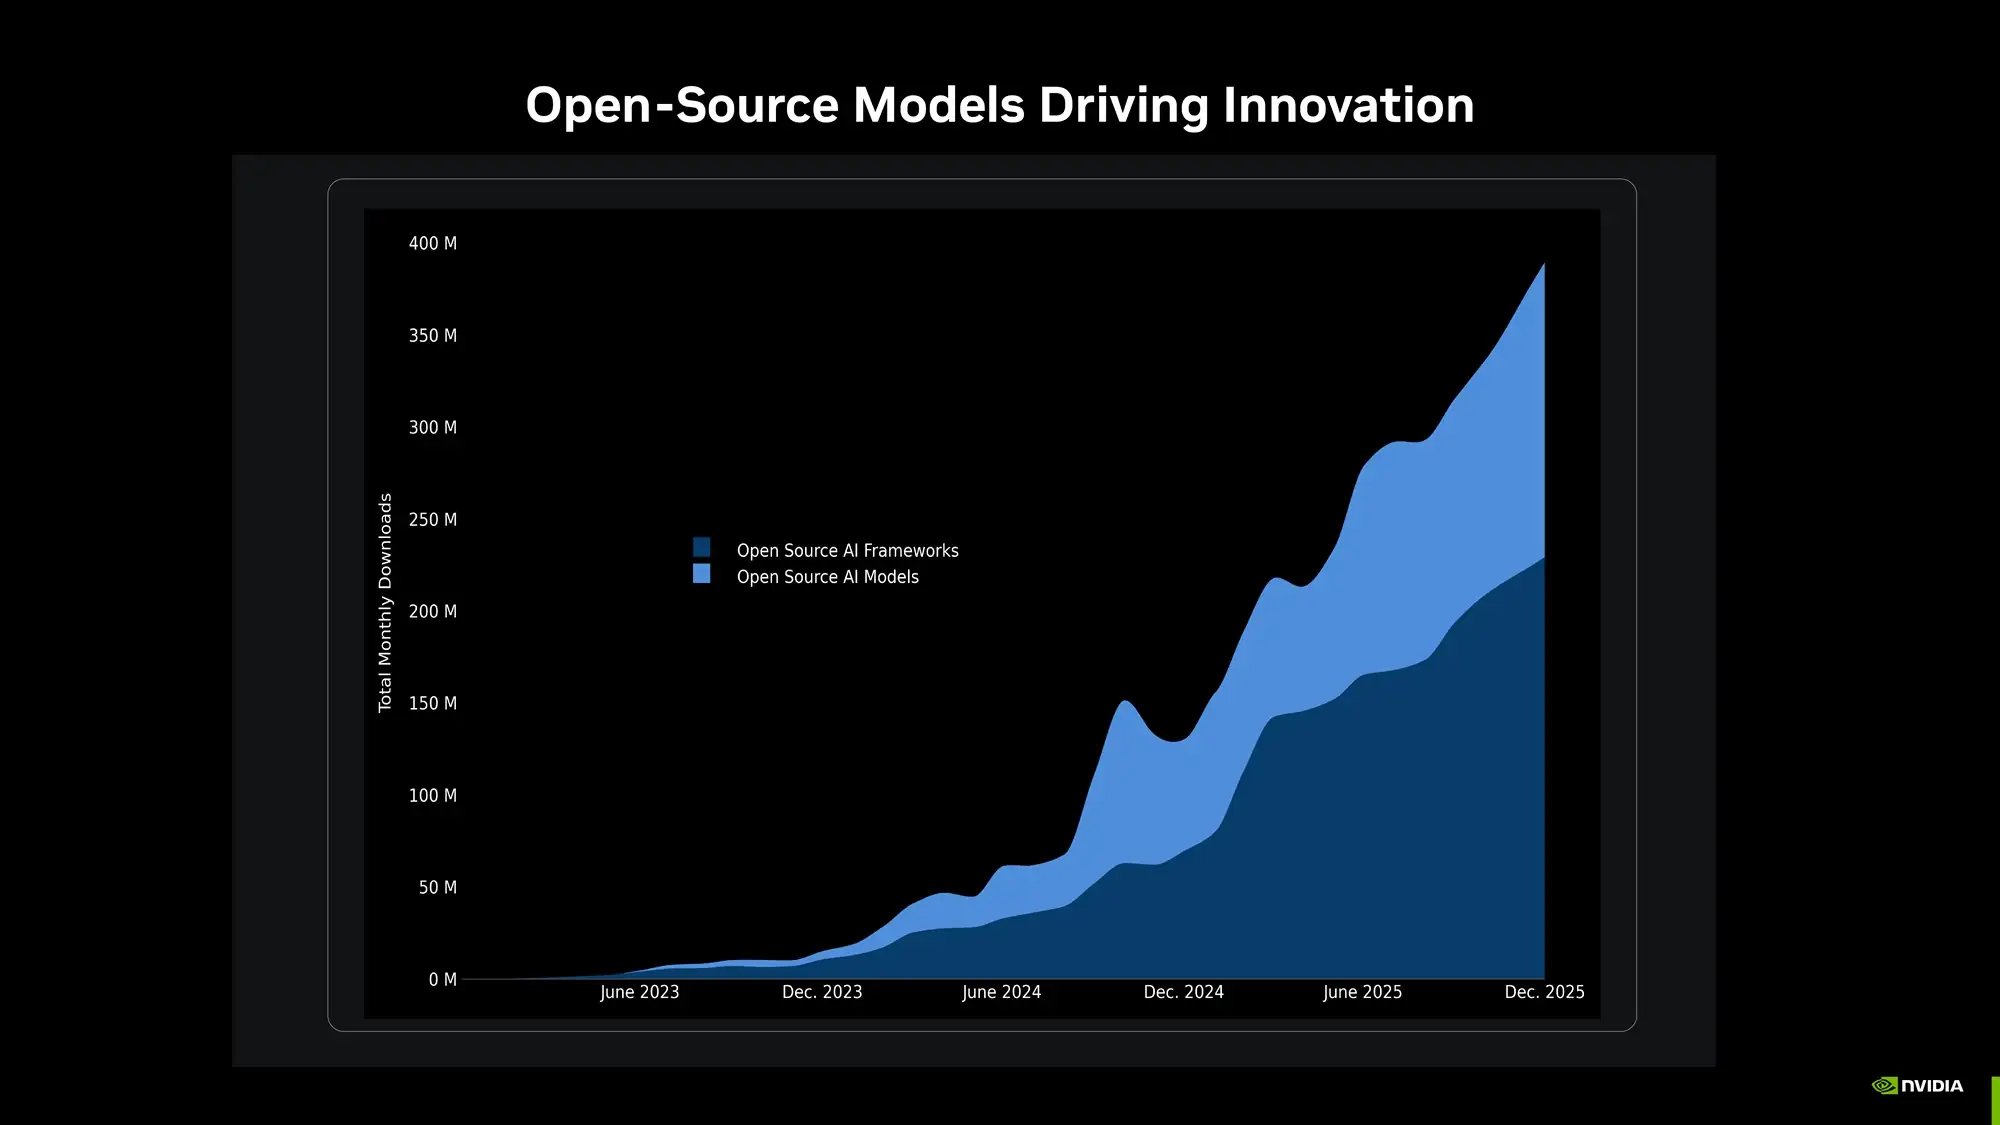
Выставка CES 2026 стала ареной для демонстрации фундаментального сдвига в индустрии искусственного интеллекта, где фокус смещается с облачных сервисов на мощные локальные вычисления. В открывающей части презентации NVIDIA привела впечатляющую аналитику, иллюстрирующую взрывной рост интереса к открытому программному обеспечению: количество ежемесячных загрузок Open Source моделей и фреймворков выросло с 50 миллионов в 2023 году до почти 400 миллионов к концу 2025 года. Этот тренд подтверждает, что разработка переходит в фазу массового внедрения, требуя от рабочих станций способности справляться с колоссальными нагрузками без постоянного обращения к дата-центрам.
Ответом на этот запрос стало обновление архитектуры DGX Spark, которая теперь позиционируется как идеальная среда для создания Agentic AI непосредственно на рабочем столе. Разработчики получают независимость от внешних API, что критически важно не только для скорости экспериментов, но и для сохранения конфиденциальности данных. Платформа трансформируется из простого инструмента для инференса в комплексную систему, способную поддерживать полный жизненный цикл автономных агентов.
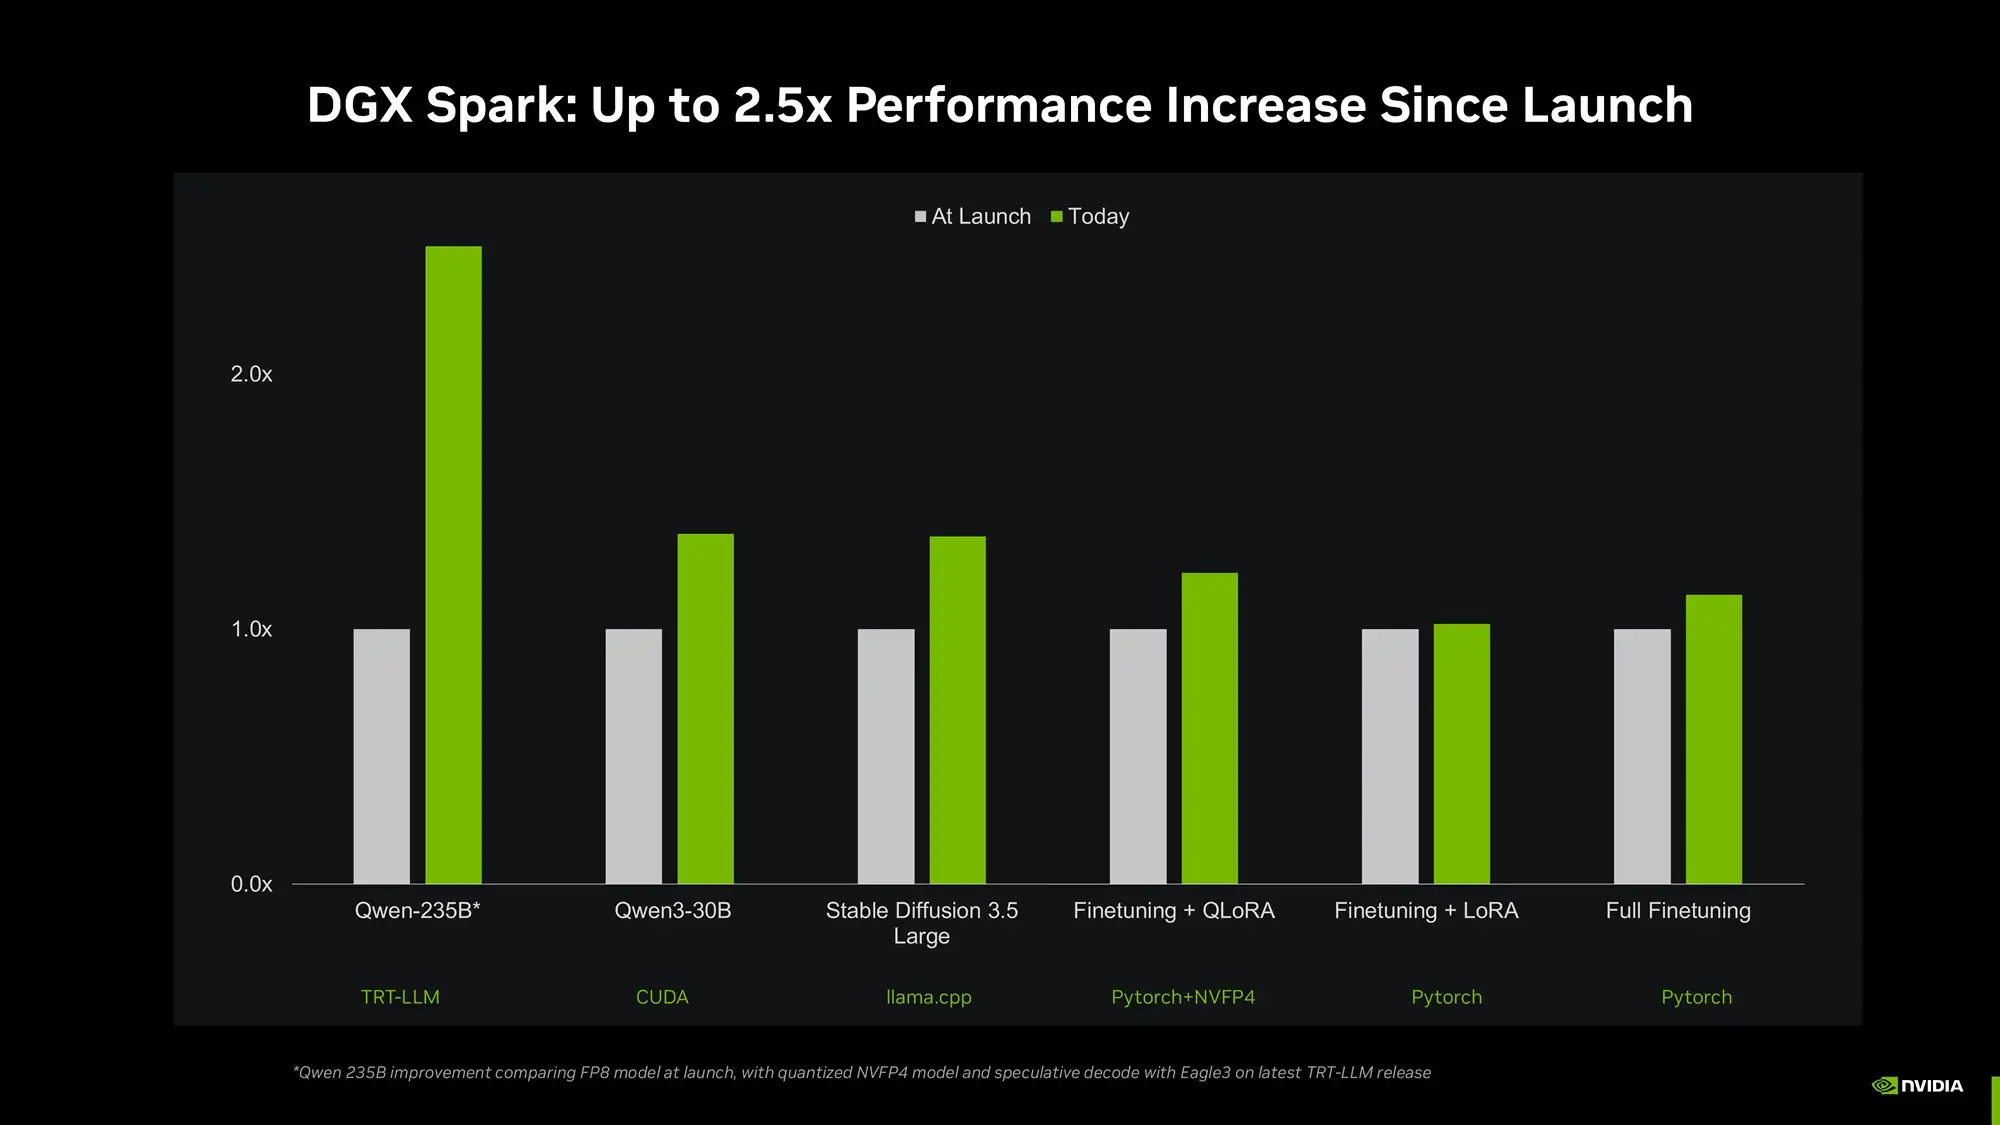
Инженеры NVIDIA совершили настоящий прорыв в оптимизации программного стека, добившись увеличения производительности платформы в 2,5 раза с момента ее первоначального запуска. Этот прирост был достигнут за счет внедрения новых форматов вычислений, таких как квантование NVFP4, которое пришло на смену формату FP8. Данное изменение позволило существенно снизить требования к памяти и пропускной способности, сделав возможным локальный запуск таких массивных моделей, как Qwen-235B, которые ранее требовали кластерных решений.
В дополнение к смене форматов, существенную роль сыграла интеграция технологии спекулятивного декодирования Eagle3 в движок TRT-LLM. Это нововведение позволяет предсказывать несколько токенов вперед, значительно ускоряя генерацию текста. Сравнительные тесты показали кратный рост скорости как для языковых моделей (Qwen3-30B), так и для тяжелых диффузионных сетей типа Stable Diffusion 3.5 Large, подтверждая эффективность программной модернизации без замены аппаратной части.
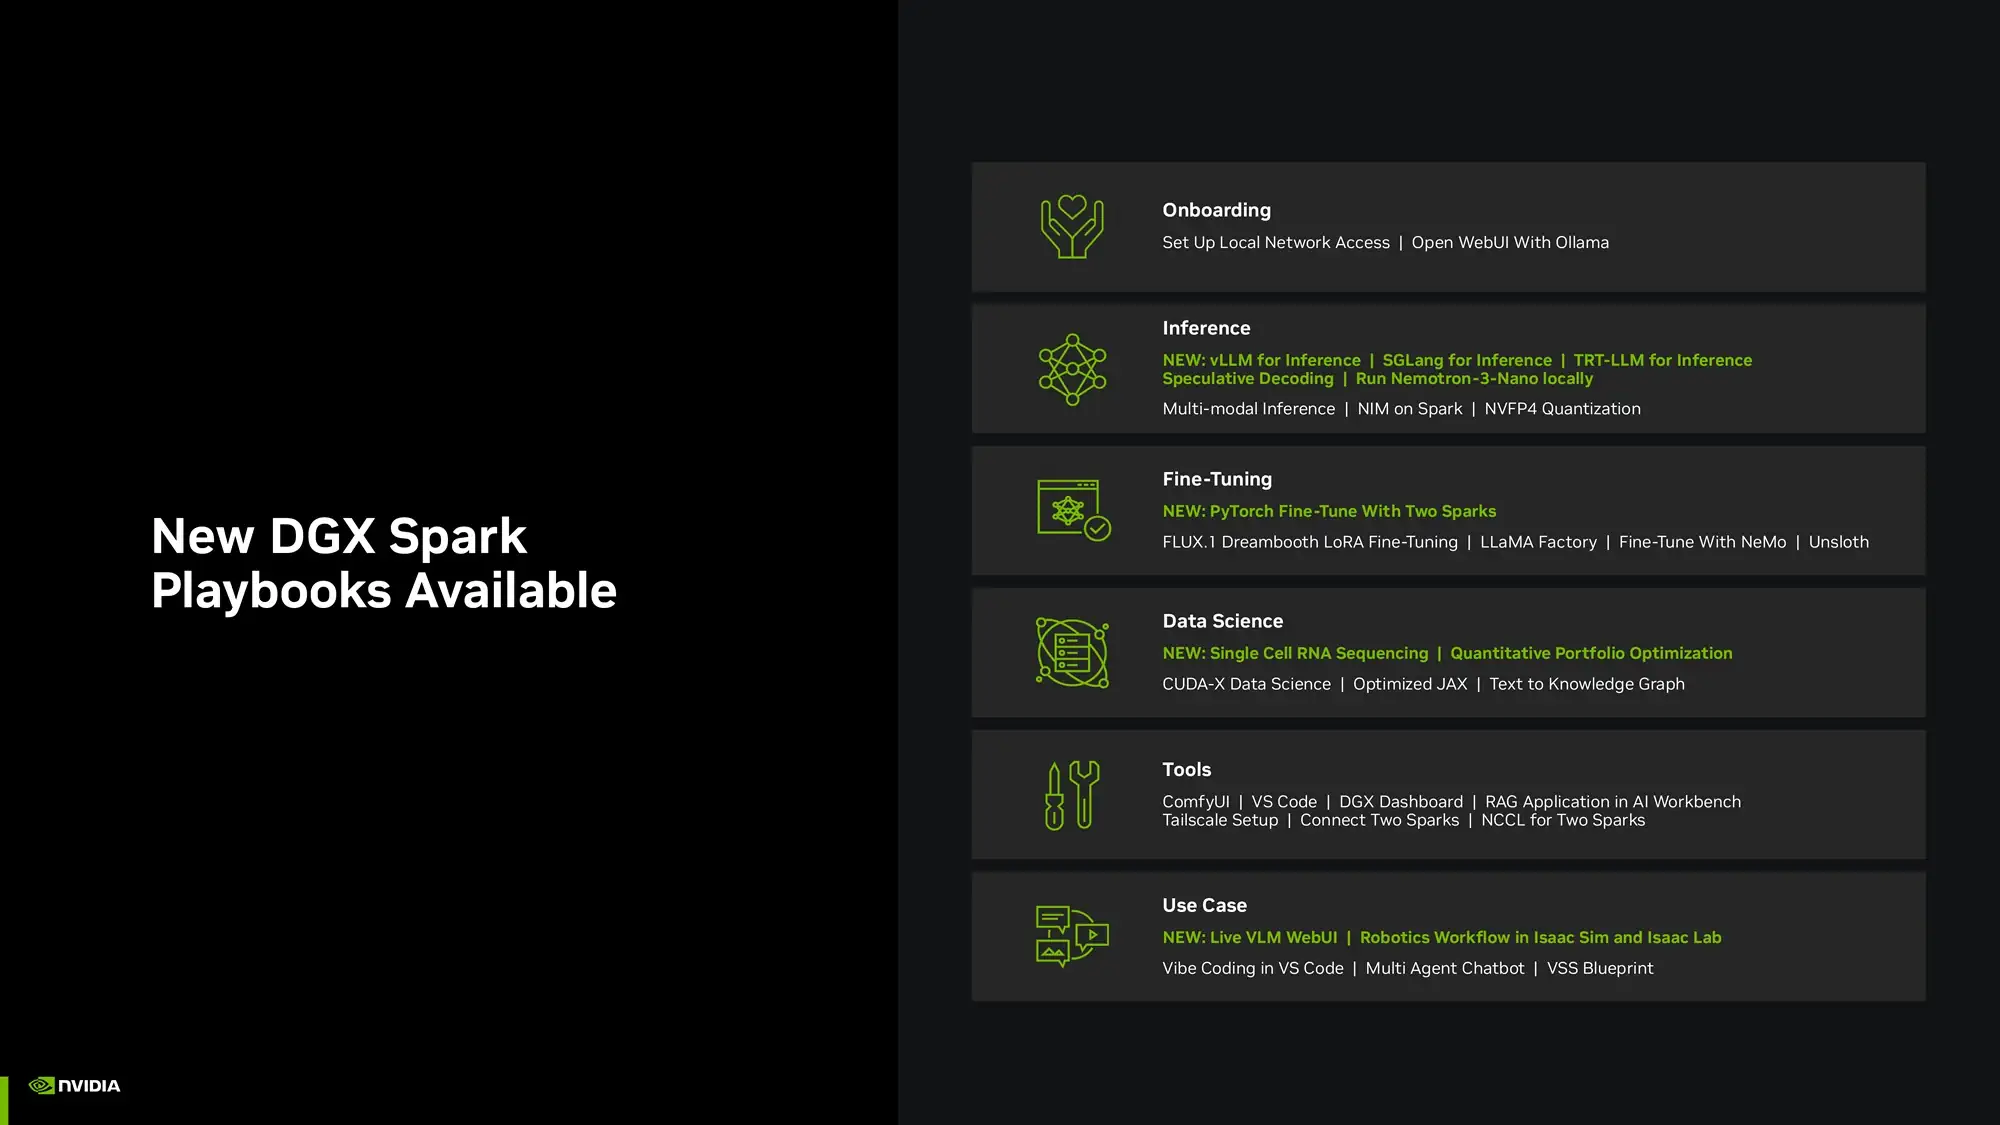
Для упрощения работы инженеров NVIDIA представила семь новых сценариев развертывания (Playbooks), охватывающих все этапы создания ИИ. В области инференса разработчики получили долгожданную свободу выбора движков: теперь платформа нативно поддерживает не только проприетарный TRT-LLM, но и популярные открытые решения VLLM и SGLang. Также реализована возможность запуска микросервисов NIM прямо на устройстве, что позволяет выстраивать архитектуру приложений, идентичную той, что используется в облачном продакшене.
Сфера дообучения моделей (Fine-Tuning) также претерпела значительные изменения благодаря функции объединения ресурсов. Технология «Connect Two Sparks» позволяет соединять две рабочие станции через высокоскоростные интерфейсы для масштабирования доступной видеопамяти, что открывает доступ к дообучению крупных моделей на базе PyTorch. Интеграция с инструментами LLAMA Factory, NeMo и методами QLoRA делает процесс адаптации нейросетей под конкретные задачи более доступным и быстрым.
Отдельный блок обновлений касается специализированных задач в области Data Science, где требуются специфические вычисления. Платформа получила оптимизированные алгоритмы для биоинформатики, в частности для секвенирования одноклеточной РНК, а также финансовые инструменты для количественной оптимизации инвестиционных портфелей. Эти задачи, традиционно требовавшие суперкомпьютерного времени, теперь решаются локально с высокой эффективностью.
Кроме того, была представлена технология преобразования неструктурированного текста в графы знаний (Text to Knowledge Graph) на базе ускоренного фреймворка JAX. Это решение позволяет создавать сложные аналитические системы и базы знаний для RAG-приложений, обеспечивая глубокий семантический анализ больших массивов данных. Локальная обработка в данном случае гарантирует, что чувствительная корпоративная информация не покидает периметр организации.
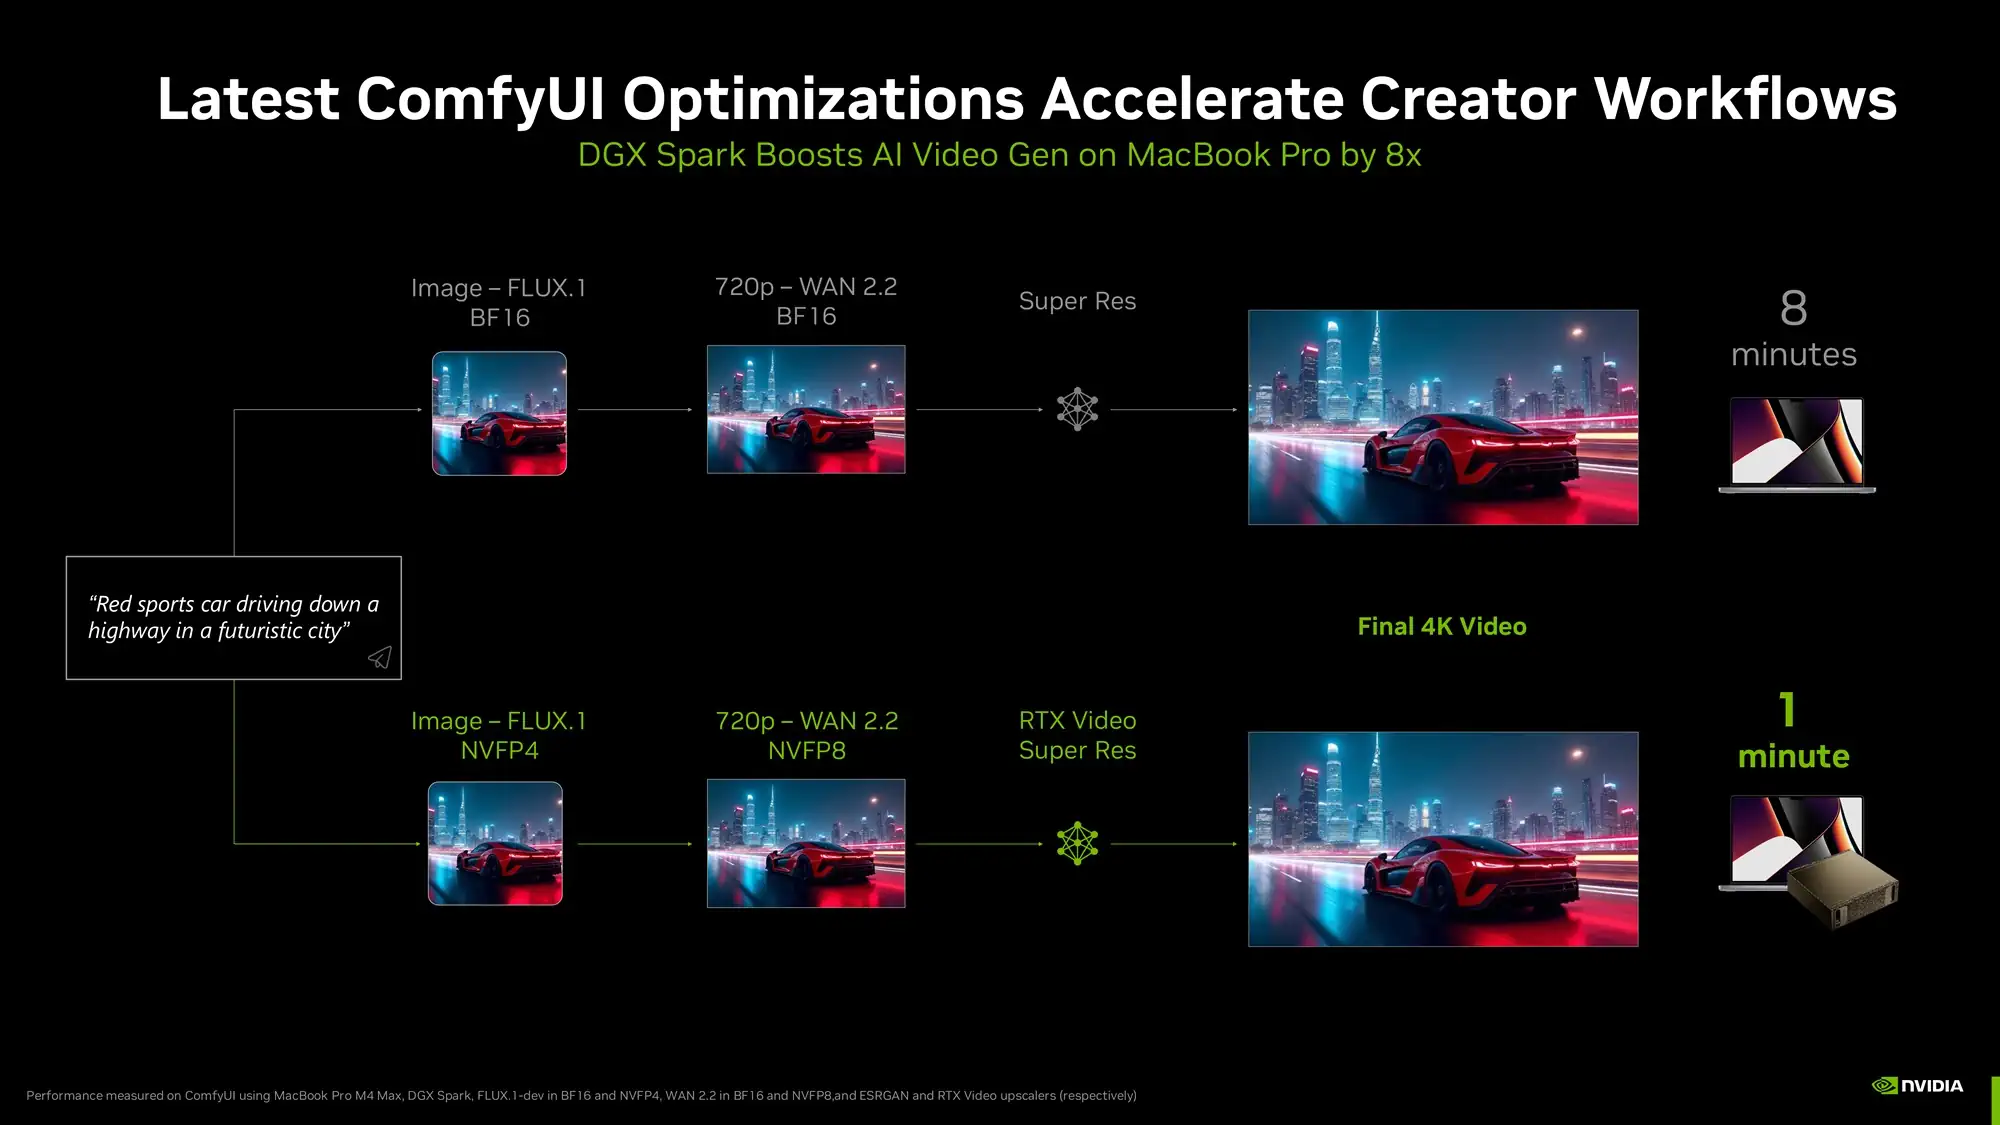
Впечатляющие результаты DGX Spark продемонстрировала в прямом сравнении с топовыми мобильными рабочими станциями, такими как MacBook Pro на чипе M4 Max. В тесте на генерацию 4K-видео с использованием связки моделей FLUX.1 и WAN 2.2 стационарная платформа NVIDIA справилась с задачей всего за одну минуту. В то же время конкуренту потребовалось на аналогичный рендеринг восемь минут, что фиксирует восьмикратное превосходство специализированного железа.
Такой разрыв в производительности объясняется наличием тензорных ядер, аппаратно ускоряющих операции в смешанной точности BF16 и NVFP8. Для создателей контента это означает кардинальное изменение рабочего ритма: вместо длительного ожидания завершения рендеринга они получают возможность итерировать идеи практически в реальном времени, используя передовые методы генерации видео и апскейлинга через RTX Video Super Resolution.
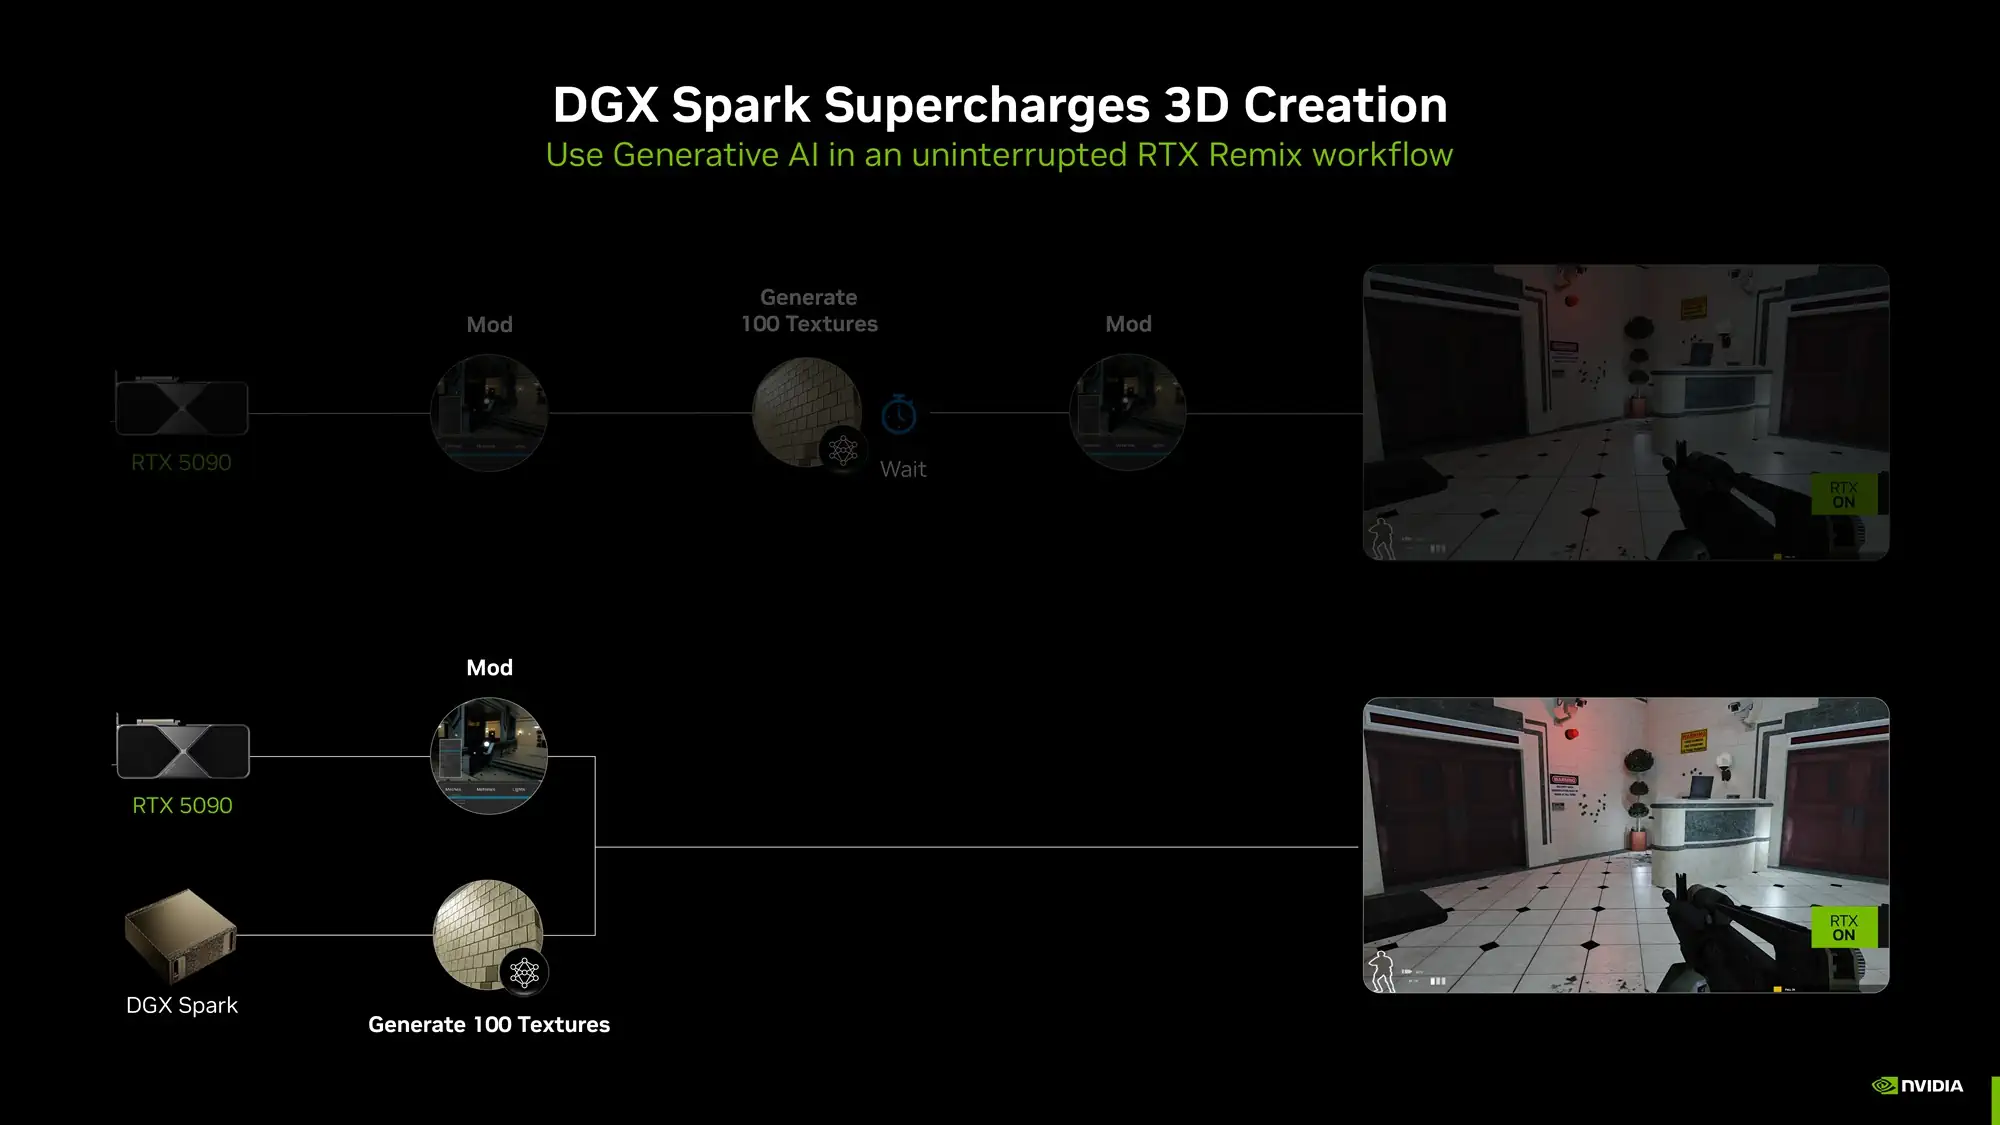
Для индустрии геймдева и моддинга было представлено обновление инструментария RTX Remix, меняющее подход к работе с текстурами. Новый конвейер обработки позволяет генерировать материалы батчами (пакетами) в фоновом режиме, распараллеливая задачи генеративного ИИ. Это устраняет необходимость простоя интерфейса во время вычислений, обеспечивая художнику непрерывный творческий процесс (uninterrupted workflow).
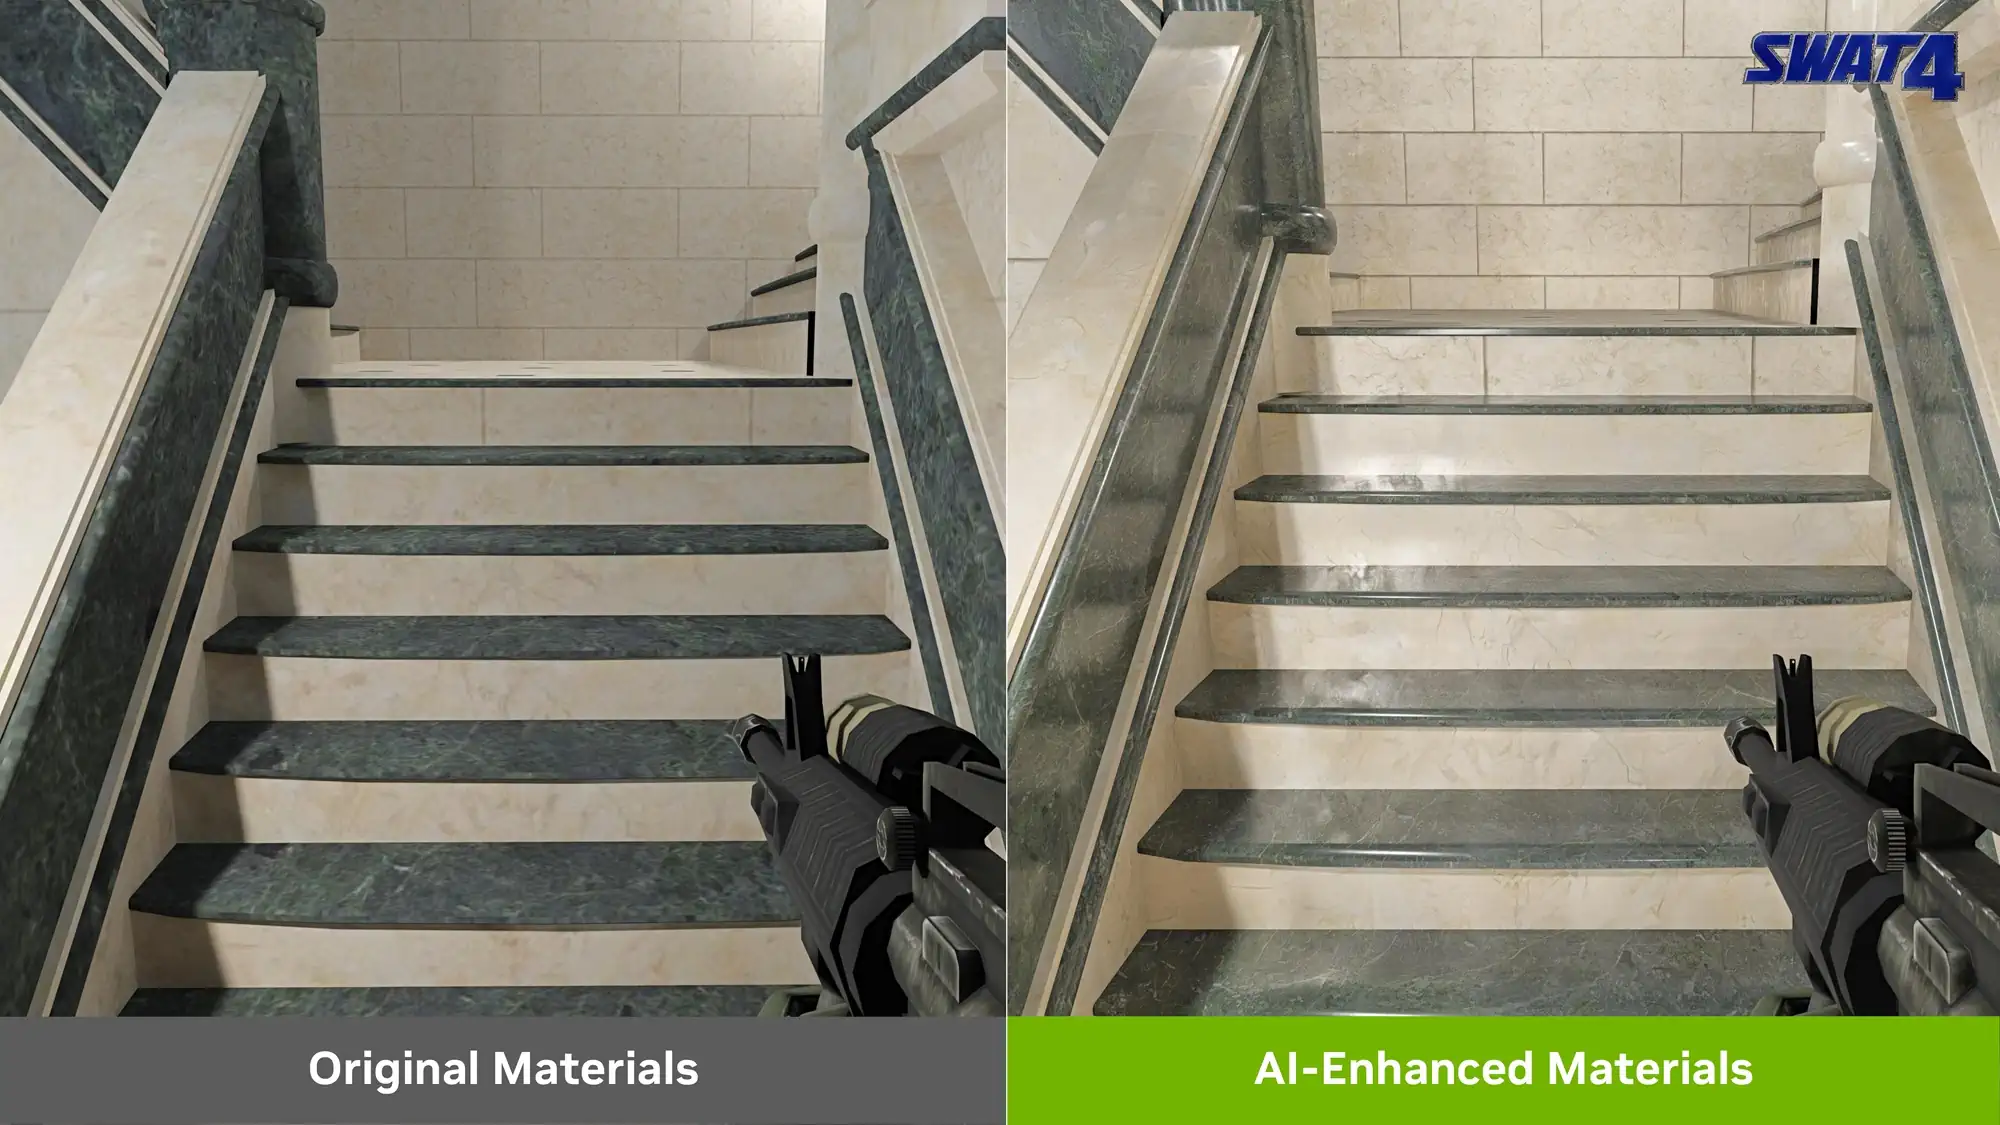
Наглядным примером эффективности технологии стала демонстрация обновления классической игры SWAT4. Нейросеть автоматически улучшила размытые текстуры оригинала, повысив их четкость и детализацию, при этом сохранив исходную стилистику. Возможность обрабатывать сотни материалов одновременно на одной машине делает ремастеринг старых игр доступным даже для небольших команд энтузиастов.
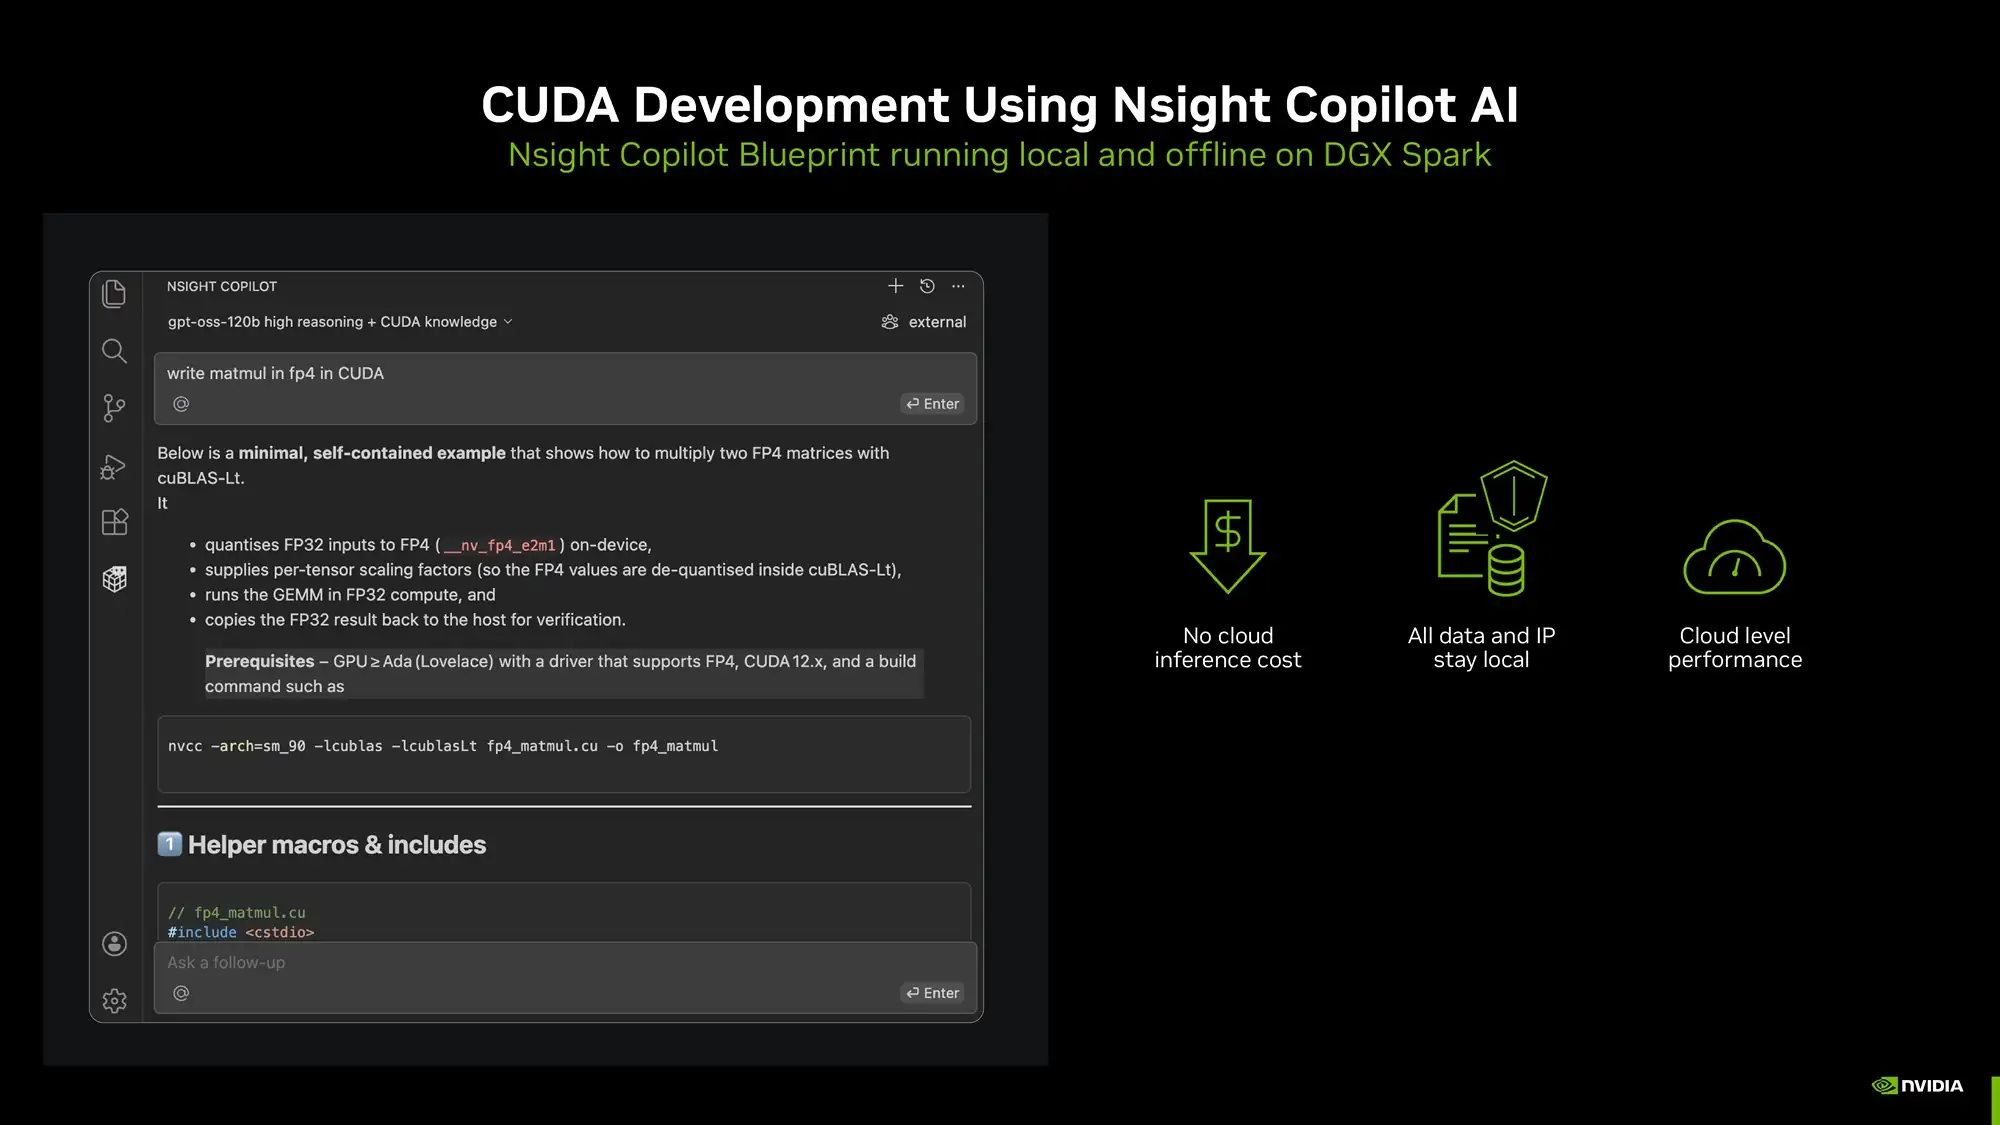
Важнейшим анонсом для программистов стал запуск локального ассистента Nsight Copilot, специализирующегося на написании кода CUDA и C++. В его основе лежит открытая модель gpt-oss-120b, глубоко дообученная на технической документации и примерах оптимизации под GPU. Ассистент способен не только генерировать эффективные ядра, но и объяснять сложные нюансы, такие как принципы квантования из FP32 в FP4.
Ключевое преимущество Nsight Copilot — полная автономность и безопасность. Весь процесс инференса происходит внутри DGX Spark, исключая передачу проприетарного кода в облако и риск утечки интеллектуальной собственности. Кроме того, это избавляет компании от затрат на оплату токенов коммерческих LLM, предоставляя при этом качество помощи уровня ведущих облачных моделей.
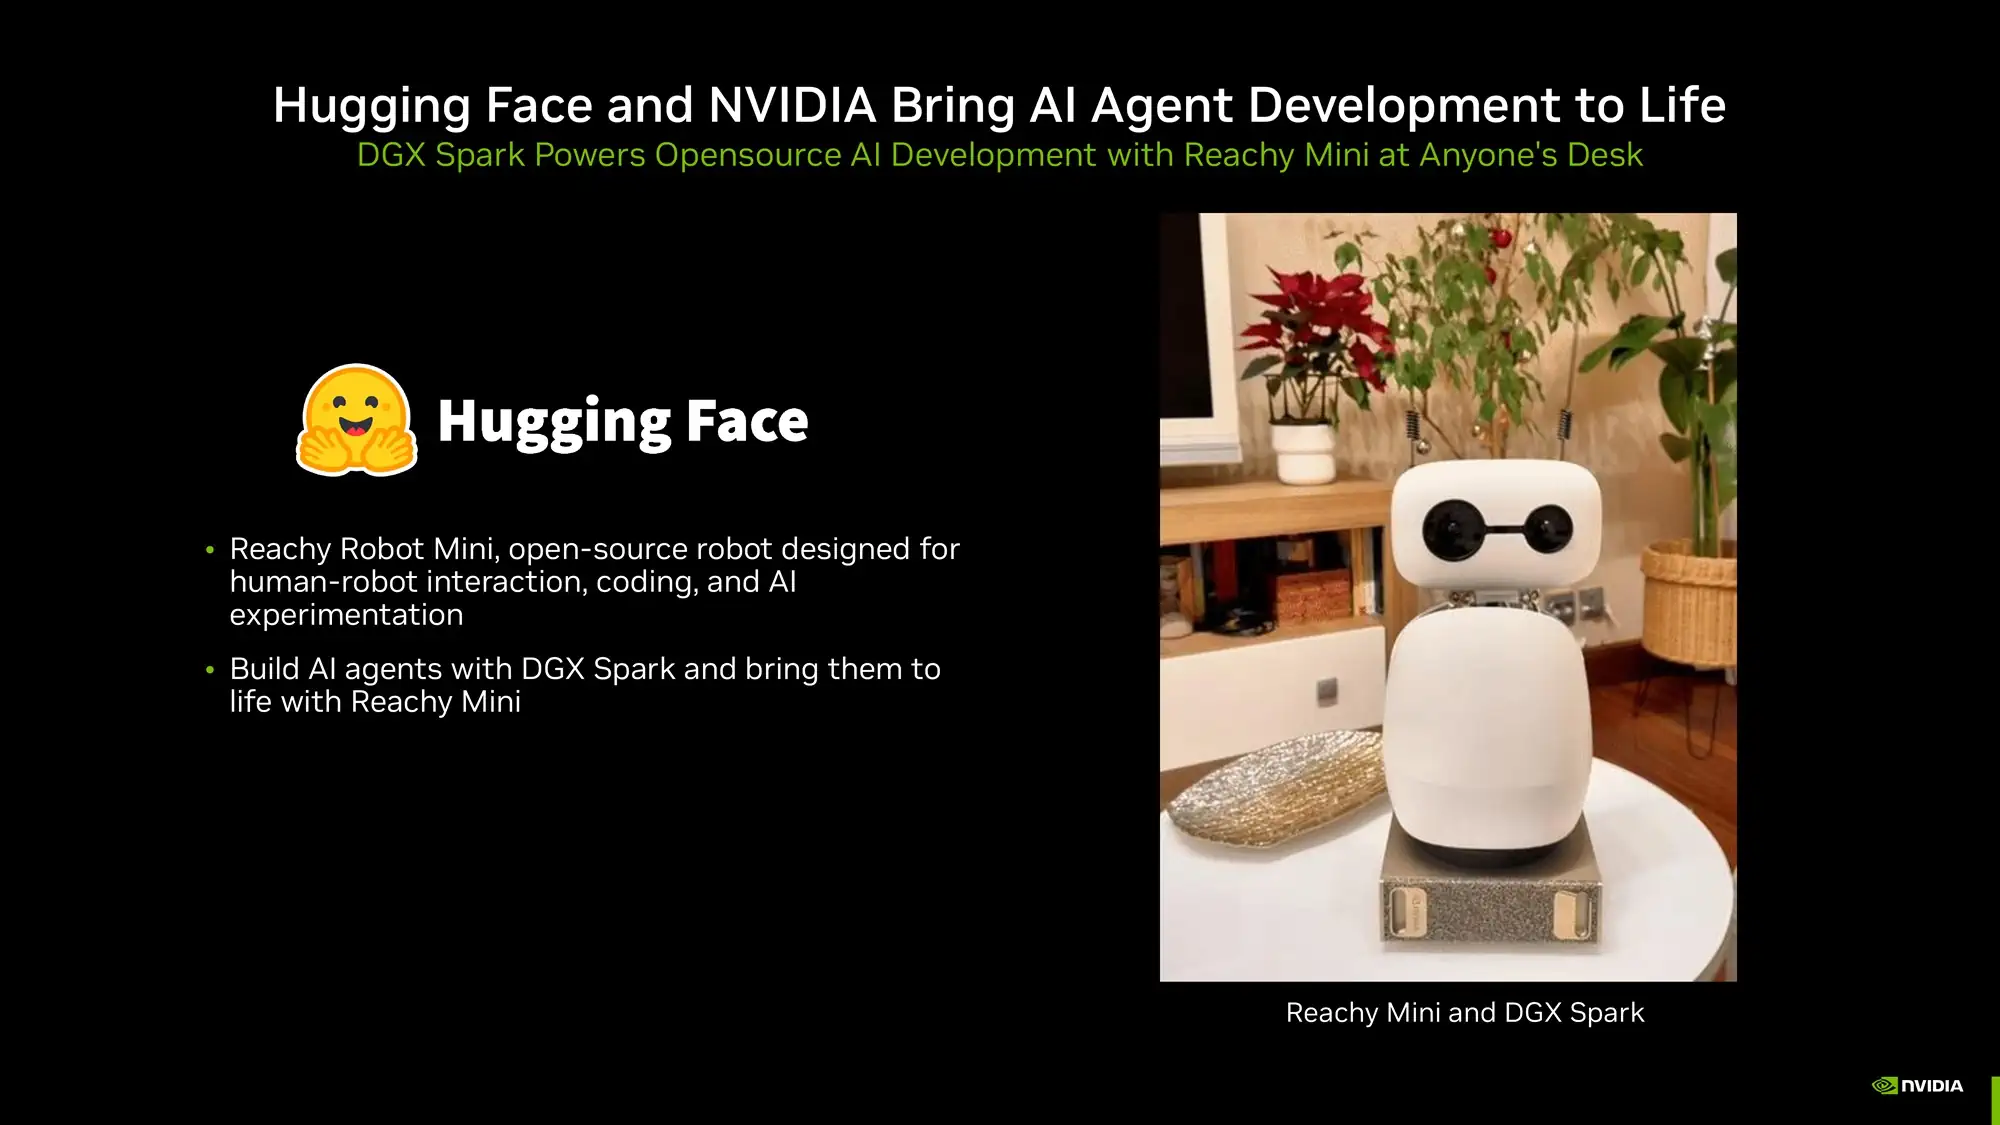
Завершает картину обновлений выход платформы в реальный физический мир через робототехнику. В партнерстве с Hugging Face была реализована поддержка открытой робо-платформы Reachy Mini. DGX Spark выступает в роли вычислительного центра, позволяя разрабатывать алгоритмы управления в симуляторах Isaac Sim и мгновенно переносить их на физического робота для тестов в реальности.
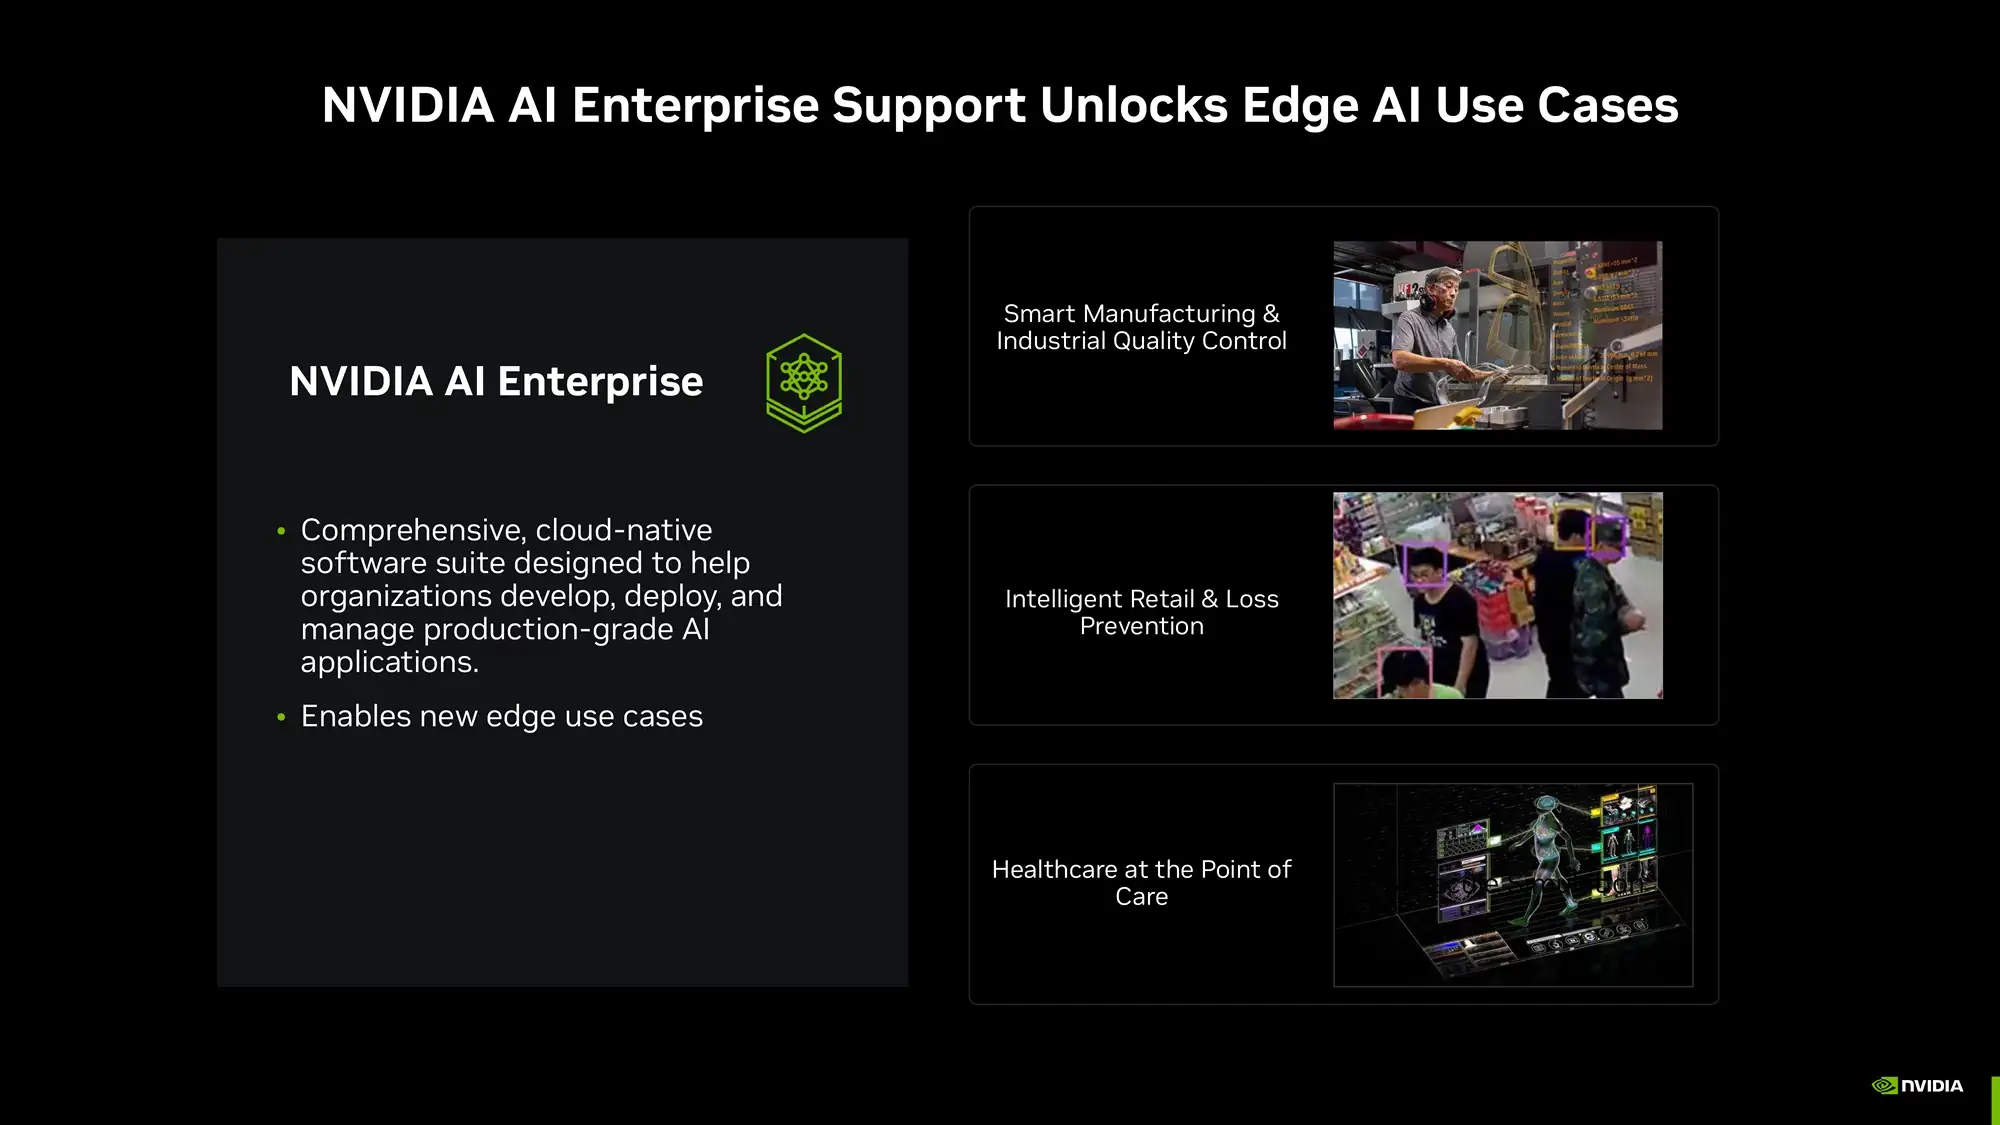
К концу января 2026 года платформа получит официальную сертификацию NVIDIA AI Enterprise. Это откроет двери для внедрения DGX Spark в критически важные отрасли, такие как здравоохранение и промышленность, предоставляя корпоративным клиентам доступ к широчайшей экосистеме партнерского ПО — от Docker и Anaconda до специализированных моделей OpenAI и Mistral — с гарантированной поддержкой и безопасностью.