

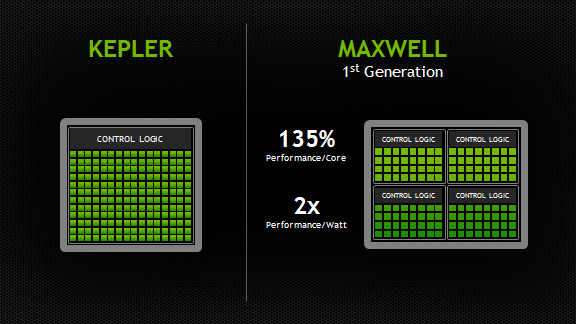
Недавний анонс графических процессоров NVIDIA на архитектуре первого поколения Maxwell – это крайне волнующий момент в индустрии GPU-вычислений. Первые продукты на архитектуре Maxwell, такие, как GeForceGTX 750 Ti, основаны на чипе GM107 и предназначены для использования в малопотребляющих устройствах – ноутбуках, компактных компьютерах и не только. Ключевым моментом Maxwellдля разработчиков HPCи других GPU-приложений является большой скачок в энергоэффективности: почте вдвое по сравнению с архитектурой Kepler, что делает Maxwell отличной базой для будущих продуктов в линейке NVIDIA Tesla. В этом посте мы расскажем о пяти главных вещах про Maxwell, которые следует знать разработчику GPU-приложений. Среди них - преимущества архитектуры, специфика нового потокового процессора Maxwell, руководства по настройке и ссылки на дополнительные ресурсы.
1. Сердце Maxwell: более эффективные мультипроцессоры
Потоковый процессор (SM) в Maxwell- его называют SMM - создан с нуля и обладает значительно большей энергоэффективностью по сравнению с предшественниками. Стоит отметить, что Kepler SMX был достаточно эффективен для своего поколения. В результате его создания инженеры NVIDIA увидели новые возможности в повышении эффективности архитектуры GPU, которые и были реализованы в SM Maxwell. Улучшения коснулись механизмов распределения управляющей логики и нагрузки, гранулярности алгоритмов энергосбережения, планирования инструкций и количества исполняемых инструкций за такт, а также многих других аспектов, позволивших SM Maxwell намного опередить Kepler SMX по эффективности. Новая архитектура SM Maxwell позволила увеличить количество SMдо пяти в GM107, в отличие от двух в GK107, при увеличении площади матрицы всего на 25%.
Улучшенное планирование инструкций
Количество ядер CUDAв одном SMсократилось, однако с учетом возросшей эффективности исполнения в Maxwell (прирост производительность в расчете на SMсоставляет в пределах 10% от производительности Kepler) и более эффективных размеров SM, общее число ядер CUDAна GPU будет намного выше, чем у Fermiи Kepler. В Maxwell SM осталось то же самое количество планировщиков инструкций и уменьшены задержки на арифметических операциях по сравнению с Kepler.
Как и в SMX, в каждом SMM есть четыре warp-планировщика, но в отличие от SMX, все ключевые функциональные блоки SMM привязаны к определенному планировщику, а не делятся между ними. Количество ядер на один раздел теперь равно степени двойки, что упрощает планирование – каждый планировщик использует свой собственный набор ядер количеством равным размеру warp`а. Warp-планировщик может по-прежнему за один такт выполнять две инструкции (например, выполняя математическую операцию на CUDA-ядрах одновременно с выполнением операции обращения к памяти в блоке load/store), однако теперь можно полностью загрузить CUDA-ядра даже если планировщик отправляет на выполнение по одной инструкции.
Увеличенная загрузка потоковых процессоров
SMMпо многим аспектам похож на SMX архитектуры Kepler, при этом ключевые изменения нового типа процессоров направлены на повышение эффективности без необходимости значительного увеличения параллелизма в расчете на SMв приложении.Размер регистрового файла (64K32-битных регистров), максимально количество warp`ов на SM (64 warp`а) и максимальное количество регистров (255 регистров) остались прежними. Максимальное количество блоков на потоковый мультипроцессор SMM удвоилось до 32, что должно привести к автоматическому увеличению загрузки для ядер, которые использую малый размер блока – 64 или меньше – в предположении, что регистры и разделяемая память не ограничивают загрузку мультипроцессора. В таблице 1 представлены в сравнении ключевые характеристики Maxwell GM107 и предшественника Kepler GK107.
Уменьшены задержки при выполнении арифметических инструкций
Еще одним значительным преимуществом SMMявляется уменьшение задержек выполнения арифметических инструкций. Так как загрузка мультипроцессора (которая преобразуется в параллелизм на уровне warp`ов) у SMM такая же или лучше, чем у SMX, сокращенные задержки улучшают использование CUDA-ядер и повышают скорость работы ядра.
|
Таблица 1. Сравнение MaxwellGM107 и KeplerGK107 |
||
|
GPU |
GK107 (Kepler) |
GM107 (Maxwell) |
|
Ядра CUDA |
384 |
640 |
|
Базовая частота |
1058 МГц |
1020 МГц |
|
Boost-частота GPU |
н/д |
1085 МГц |
|
GFLOPs |
812.5 |
1305.6 |
|
Compute Capability |
3.0 |
5.0 |
|
Разделяемая память / SM |
16 КБ / 48 КБ |
64 КБ |
|
Размер регистрового файла / SM |
256 КБ |
256 КБ |
|
Максимальное кол-во блоков / SM |
16 |
32 |
|
Частота памяти |
5000 МГц |
5400 МГц |
|
Полоса пропускания памяти |
80 ГБ/с |
86.4 ГБ/с |
|
Размер кэша L2 |
256 КБ |
2048 КБ |
|
TDP |
64 Вт |
60 Вт |
|
Транзисторы |
1.3 млрд. |
1.87 млрд. |
|
Площадь кристалла |
118 мм2 |
148 мм2 |
|
Техпроцесс |
28 нм |
28 нм |
2. Увеличенная выделенная общая память
В архитектуре Maxwell предусмотрено 64 кбайт разделяемой памяти, в то время как в Fermiили Keplerэта память делится между L1-кэшом и разделяемой памятью. В Maxwell один блок по-прежнему может использовать до 48 кбайт разделяемой памяти, причем увеличение общего объема разделяемой памяти может привести к увеличению загрузки мультипроцессора. Это стало возможным благодаря объединению функциональности L1-кэша и текстурного-кэша в отдельном блоке.
3. Быстрые атомарные операции в разделяемой памяти
В архитектуре Maxwellпоявились встроенные атомарные операции над 32-битными целыми числами в разделяемой памяти, а также CAS-операции над 32-битными и 64-битными значениями в разделяемой памяти – с помощью них можно реализовать другие атомарные функции. В случае Kepler и Fermi приходилось использовать сложный принцип "Lock/Update/Unlock", что приводило к дополнительным издержкам.
4. Динамический параллелизм
Динамический параллелизм, появившийся в KeplerGK110, позволяет GPUсамому создавать задачи для себя. Поддержка этой функции была впервые добавлена в CUDA 5.0, позволяя нитям на GK110запускать дополнительные ядра на том же GPU.
Теперь динамический параллелизм поддерживается во всей продуктовой линейке, включая даже такие экономичные чипы, как GM107. Разработчикам это на руку, так как теперь для приложений не требуется создавать специальные алгоритмы для high-end GPU, отличающиеся от тех, которые используются на графических процессорах более низкого уровня.
5. Подробнее о программировании Maxwell
Подробнее об архитектуре и оптимизации кода под Maxwell смотрите в Руководстве по настройке Maxwell и Руководстве по совместимости Maxwell, которые уже доступны для зарегистрированных разработчиков CUDA. Авторизуйтесь или бесплатно вступайте в сообщество уже сегодня.
{extravote 5}